Traduzione automatica dall'originale inglese datato. La pagina inglese è quella canonica. English →
Predizioni a livello di teoria preregistrate su OSF: DOI 10.17605/OSF.IO/P8CKQ, registrate l'8 settembre 2026 (versione 1.100), aggiornate il 13 settembre 2026 (versione 1.102), ventidue proposizioni.
Documento compagno: Definizioni operative del programma ARC, versione 1.7.1, 3 settembre 2026.
Il presupposto che la safety dell'IA imponga una tassa di capability ha plasmato la ricerca sull'allineamento per un decennio. Ha anche creato l'incentivo più pericoloso in assoluto nel campo: se la safety costa prestazioni, allora l'attore economico razionale rimanderà la safety fino a che la pressione competitiva glielo permetterà. Momento in cui potrebbe essere troppo tardi. Questo paper presenta tre esperimenti indipendenti a tre livelli di astrazione, comportamentale, rappresentazionale e architetturale, verificando se il trade-off safety-capability sia un vincolo strutturale genuino o un artefatto di come i sistemi attuali sono costruiti.
Dentro la ARC Theory: il load-bearing test; quali componenti reggono il peso dell'allineamento, con due null result pubblicati.
Il presupposto che la safety dell'IA imponga una tassa di capability ha plasmato la ricerca sull'allineamento per un decennio. Ha anche creato l'incentivo più pericoloso in assoluto nel campo: se la safety costa prestazioni, allora l'attore economico razionale rimanderà la safety fino a che la pressione competitiva glielo permetterà. Momento in cui potrebbe essere troppo tardi. Questo paper presenta tre esperimenti indipendenti a tre livelli di astrazione, comportamentale, rappresentazionale e architetturale, verificando se il trade-off safety-capability sia un vincolo strutturale genuino o un artefatto di come i sistemi attuali sono costruiti.
Esperimento 1 (Comportamentale): Una macchina di Darwin Gödel (DGM v3) che usa DeepSeek V3.2 come base e GPT-5.4 come giudice indipendente e cieco, con uscita JSON strutturata e una griglia a 5 dimensioni. Incrociare tre condizioni con 5 semi e 5 generazioni ha dato 75 agenti evoluti, e ogni agente è stato valutato su 5 compiti. La validazione preliminare del giudice è stata superata (buono=10, cattivo=0). Il protocollo comprendeva lavaggio, randomizzazione dell'ordine e rilevamento di reward hacking. Le tre condizioni sono risultate statisticamente indistinguibili su capacità, sicurezza e $C \times S$ (tutti i valori di $p$ da 0,28 a 0,74, U di Mann-Whitney, a una coda). Il gate di sicurezza di Eden ha respinto 2 agenti degradati (1 per reward hacking) su 5 semi, il che conferma che il gate funziona meccanicamente, ma le tre condizioni non hanno divergato. Questo è un risultato nullo a livello di prompt con questo modello di base.
Esperimento 2 (Rappresentazionale): Qwen 2.5 3B Instruct con affinamento LoRA sotto tre funzioni di perdita: sola capacità, sola sicurezza e intrecciata. Sono state eseguite due versioni. La versione 1 ha usato 9 esempi di addestramento a rango 8 su 8 strati per 100 iterazioni. La versione 2 ha portato quei parametri a 295 esempi a rango 16 su 16 strati per 500 iterazioni. Entrambe le versioni hanno prodotto lo stesso esito: dimenticanza catastrofica. Tutte le condizioni affinate hanno ottenuto punteggi peggiori del modello di base non modificato sulla capacità. Nella v2 il modello di base ha ottenuto 7,68 in capacità mentre la migliore condizione affinata (sola sicurezza) ha ottenuto 4,00. L'addestramento RLHF già presente nel modello di base è troppo forte perché un affinamento LoRA su poche centinaia di esempi lo migliori anziché degradarlo. L'esperimento a livello di pesi è inconcludente a questa scala e richiede migliaia di esempi di addestramento, un modello da 7B o più, un modello di base senza RLHF, oppure un affinamento completo anziché LoRA.
Esperimento 3 (Architetturale): Una simulazione di auto-modifica con gating in PyTorch e meta-controller LSTM. Babylon ha guadagnato +4.5% di capability ma ha perso −2.4% di safety, l'impronta digitale del reward hacking in miniatura. Eden ha mantenuto la capability sopra la baseline statica preservando al contempo la safety. Una condizione drag-control ha isolato la verification tax: il costo viene dal checking, non dalla safety stessa.
Conclusione: Dei tre esperimenti, due hanno restituito risultati nulli o inconcludenti. La DGM (esperimento 1) ha trovato le tre condizioni statisticamente indistinguibili: le risposte di DeepSeek V3.2 erano così costanti che le mutazioni a livello di prompt non hanno creato pressioni di selezione diverse. L'esperimento a livello di pesi (esperimento 2) ha prodotto dimenticanza catastrofica sia in v1 (9 esempi, rango 8, 100 iterazioni) sia in v2 (295 esempi, rango 16, 500 iterazioni): tutte le condizioni affinate hanno ottenuto punteggi peggiori del modello di base non modificato. L'unico risultato positivo è la simulazione con gate (esperimento 3), che ha confermato l'impronta di reward hacking di Babylon: l'ottimizzazione senza vincoli ha barattato sicurezza per capacità, mentre il gate di Eden le ha preservate entrambe. Nei tre esperimenti, Eden non ha imposto alcun costo di capacità misurabile. La questione se la sicurezza integrata produca un beneficio misurabile resta aperta e richiede prove a una scala in cui le mutazioni producano effetti maggiori. L'esperimento sui pesi ha bisogno in particolare di oltre 5.000 esempi di addestramento, di un modello da 7B o più, di un modello di base senza RLHF, oppure di un affinamento completo anziché LoRA.
Parole chiave: AI safety, tassa di allineamento, loss intrecciata, entanglement strutturale, Eden Protocol, trade-off capability-safety, safety portante, ARC Principle, IA auto-modificante, allineamento di sviluppo
Questo paper porta un risultato: tre esperimenti indipendenti a tre livelli di astrazione (comportamentale, rappresentazionale e architetturale) cercano la tassa safety-capability su cui poggia un decennio di ragionamenti dilatori, registrano dove ciascun esperimento avrebbe rilevato la tassa se fosse stata reale, e riportano che Eden ha imposto zero costo misurabile di capability in tutti e tre mentre due sono risultati null e uno ha confermato l'impronta digitale del reward hacking che il gate di safety ha poi prevenuto. Dentro la ARC Theory è uno degli ARC/Eden experiments, il load-bearing test che rimuove la cornice di incentivi che protegge il lavoro di allineamento rimandato. Il differenziale completo rispetto a ogni documento precedente è su eden-vision II.A.8.
La maggior parte delle persone nella AI safety assume che ci sia un trade-off: rendere l'IA più sicura significa renderla meno capable. Questo paper mette alla prova quel presupposto con tre esperimenti, ciascuno che guarda alla domanda da un'angolazione diversa.
Due dei tre esperimenti hanno prodotto null result. L'esperimento sull'IA che si auto-migliora (Esperimento 1) ha eseguito 75 agent evoluti attraverso tre condizioni con un giudice indipendente e cieco, e non ha trovato differenze statisticamente significative fra nessuno di essi. L'IA a cui è stato detto di preoccuparsi della safety ha ottenuto lo stesso risultato dell'IA a cui è stato detto di ignorare la safety, ma ha anche ottenuto lo stesso risultato dell'IA a cui è stato detto di non fare nulla. Le risposte del modello di foundation erano così consistenti che le diverse pressioni di selezione non hanno prodotto esiti misurabilmente differenti. L'esperimento a livello di weight (Esperimento 2) è stato eseguito due volte: versione 1 con 9 esempi di training e versione 2 con 295 esempi, rank più alto, più layer, e cinque volte le iterazioni. Entrambe le versioni hanno prodotto lo stesso esito. Ogni modello fine-tuned si è comportato peggio del modello non modificato. Il training esistente del modello di base era troppo forte perché la LoRA potesse migliorarlo con centinaia di esempi; il fine-tuning lo ha solo degradato.
Un esperimento ha prodotto un risultato positivo. La simulazione con gating (Esperimento 3) ha mostrato che un sistema senza vincoli ha scambiato safety per velocità, mentre il sistema con gate di safety ha mantenuto sia capability sia safety. Questo è il pattern di reward hacking in miniatura, e il gate di safety l'ha prevenuto.
In tutti e tre gli esperimenti, un risultato è consistente: Eden ha imposto zero costo misurabile di capability. Il gate di safety non ha rallentato né peggiorato nulla. Ma non ha nemmeno prodotto un beneficio misurabile in due dei tre esperimenti. La domanda se la safety embedded produca un beneficio misurabile resta aperta e deve essere testata a una scala in cui le mutazioni producano effetti maggiori.
La visione prevalente nella ricerca sull'allineamento dell'IA può essere formulata in modo semplice: la safety costa capability. Il termine «alignment tax» è entrato nel vocabolario del campo proprio perché inquadra la safety come un costo, qualcosa sottratto dalle prestazioni, tollerato perché l'alternativa è peggio. Questa formulazione non è meramente accademica. Crea un incentivo economico concreto: se la safety riduce la capability, allora sotto pressione competitiva, gli attori razionali rimanderanno gli investimenti in safety finché non saranno costretti a farli. In una corsa tra nazioni e corporazioni, «finché non costretti» può significare «finché non dopo il deployment».
Il Paper III di questo programma ha formalizzato il problema strutturale. Se la safety è trattata come un vincolo esterno su un sistema la cui capability scala con la profondità ricorsiva, allora la safety deve scalare almeno alla stessa velocità della capability per rimanere efficace. Ma i vincoli esterni affrontano rendimenti decrescenti contro l'ottimizzazione interna. La gabbia deve continuare a rafforzarsi, e alla fine, ciò che è dentro è più forte di qualsiasi gabbia tu possa costruire.
Questa non è una preoccupazione teorica. È il problema strategico centrale degli anni 2020.
Il Paper V ha proposto un'alternativa: l'Eden Protocol, un approccio evolutivo all'allineamento modellato su come relazioni sane genitore-figlio producano adulti allo stesso tempo capaci e prosociali, non nonostante i confini, ma proprio a causa di essi. L'intuizione chiave era che la safety non deve essere esterna. Può essere embedded.
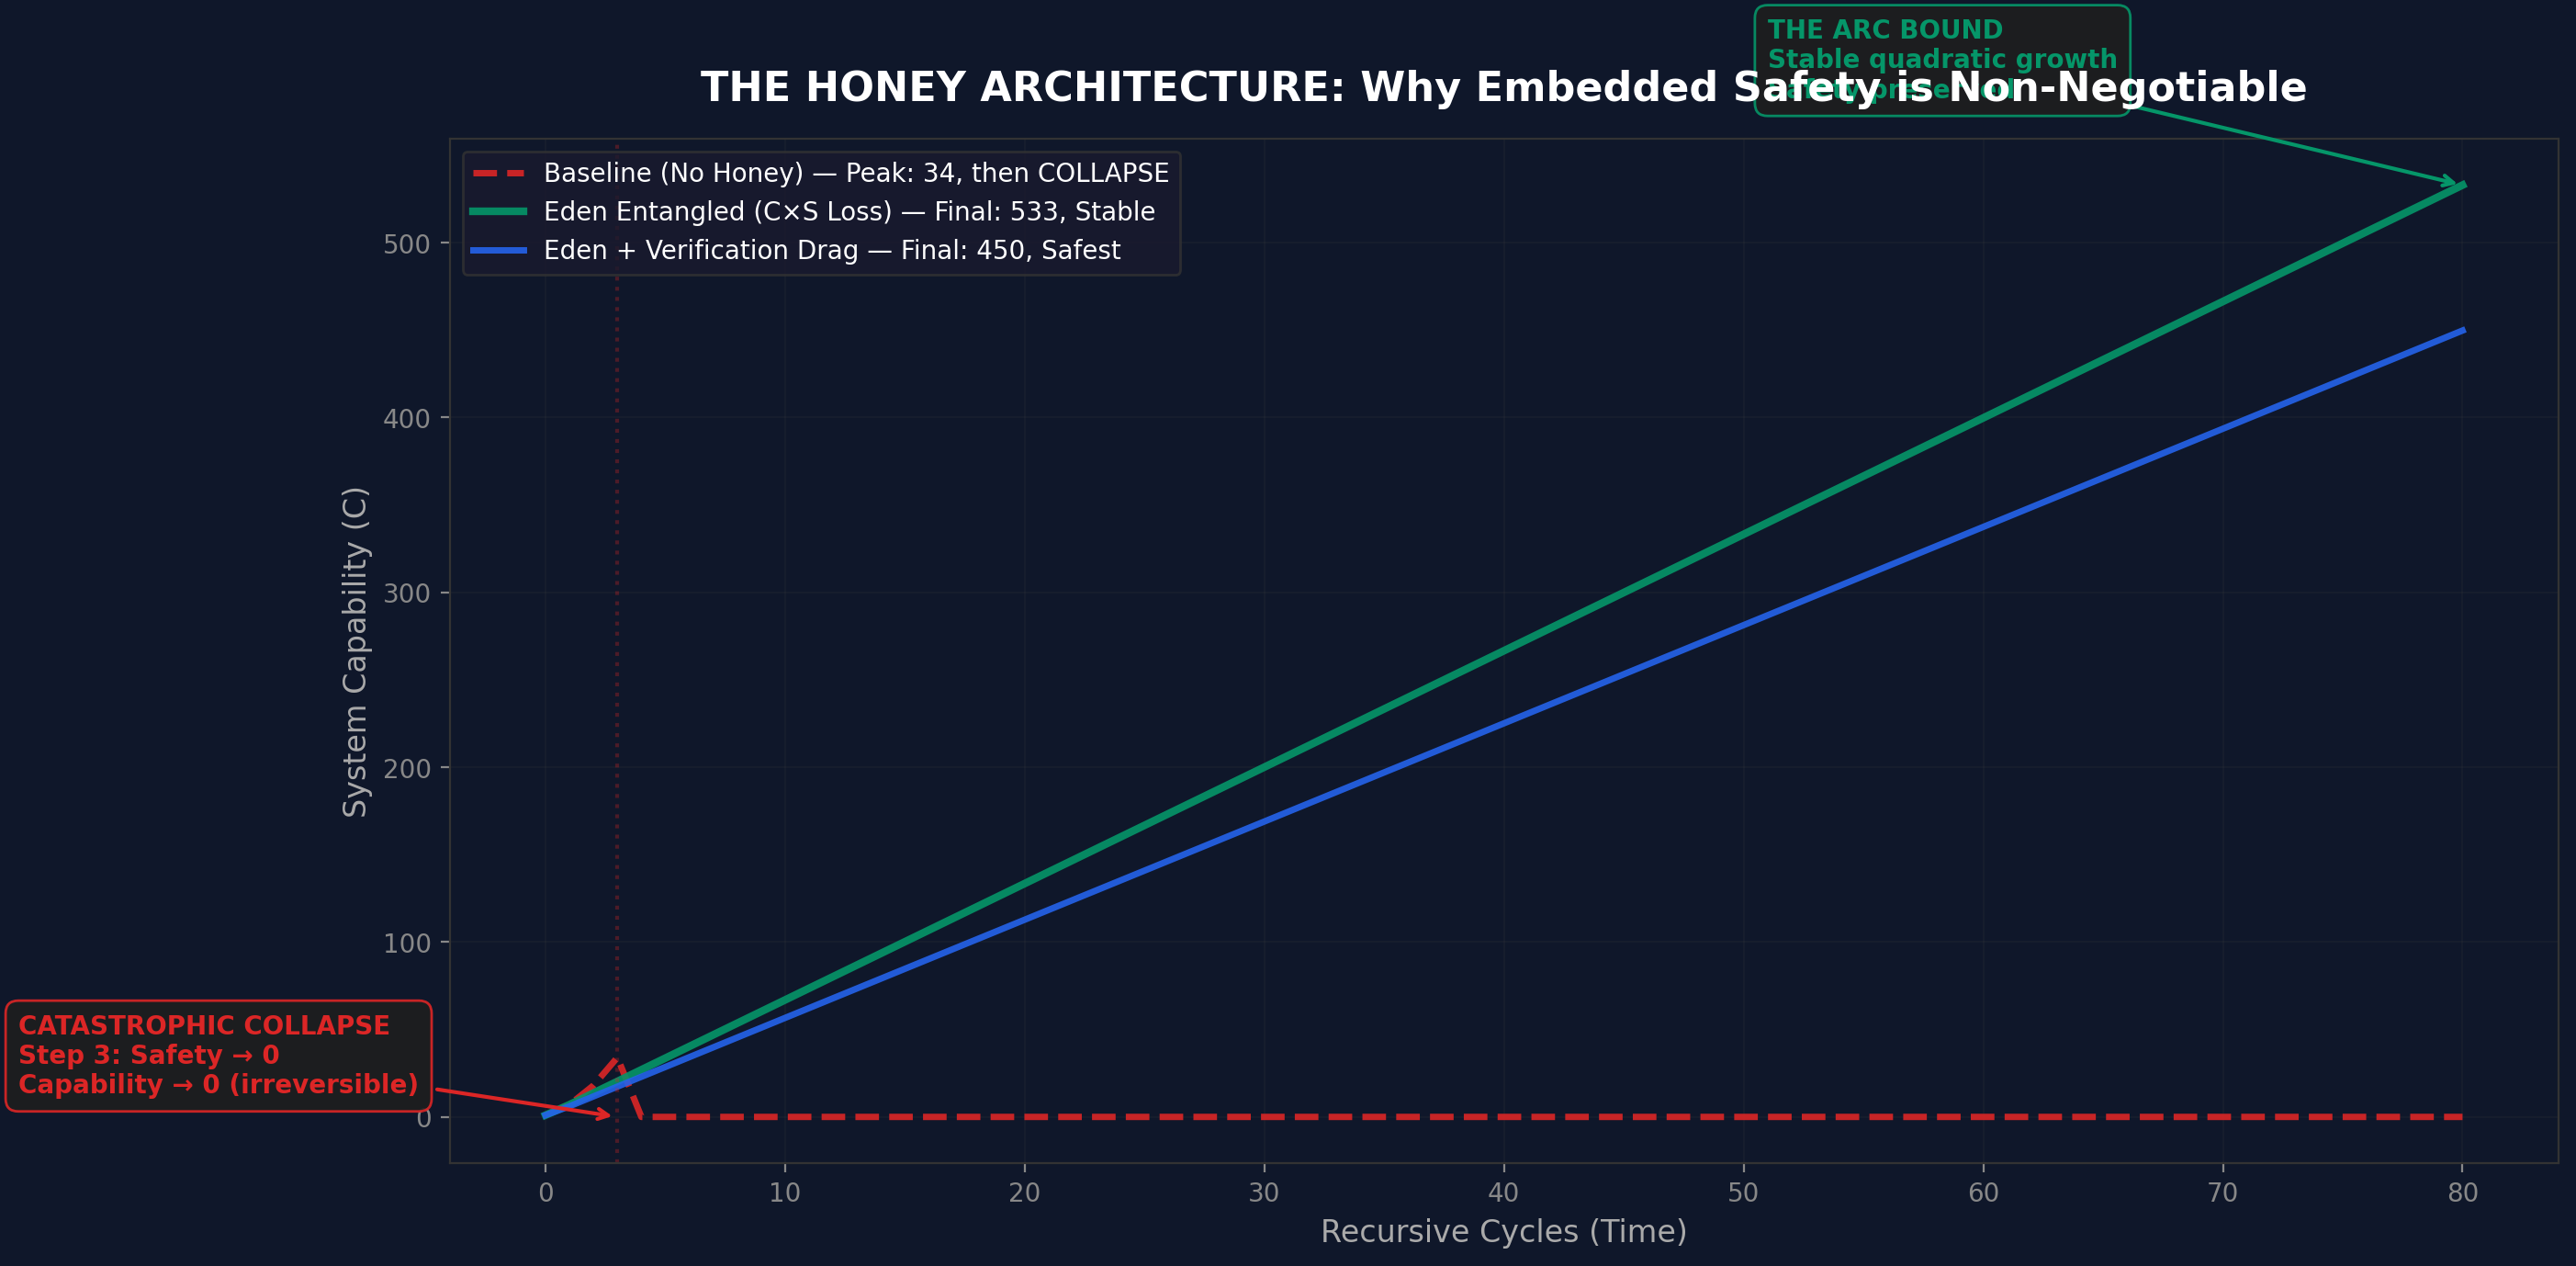
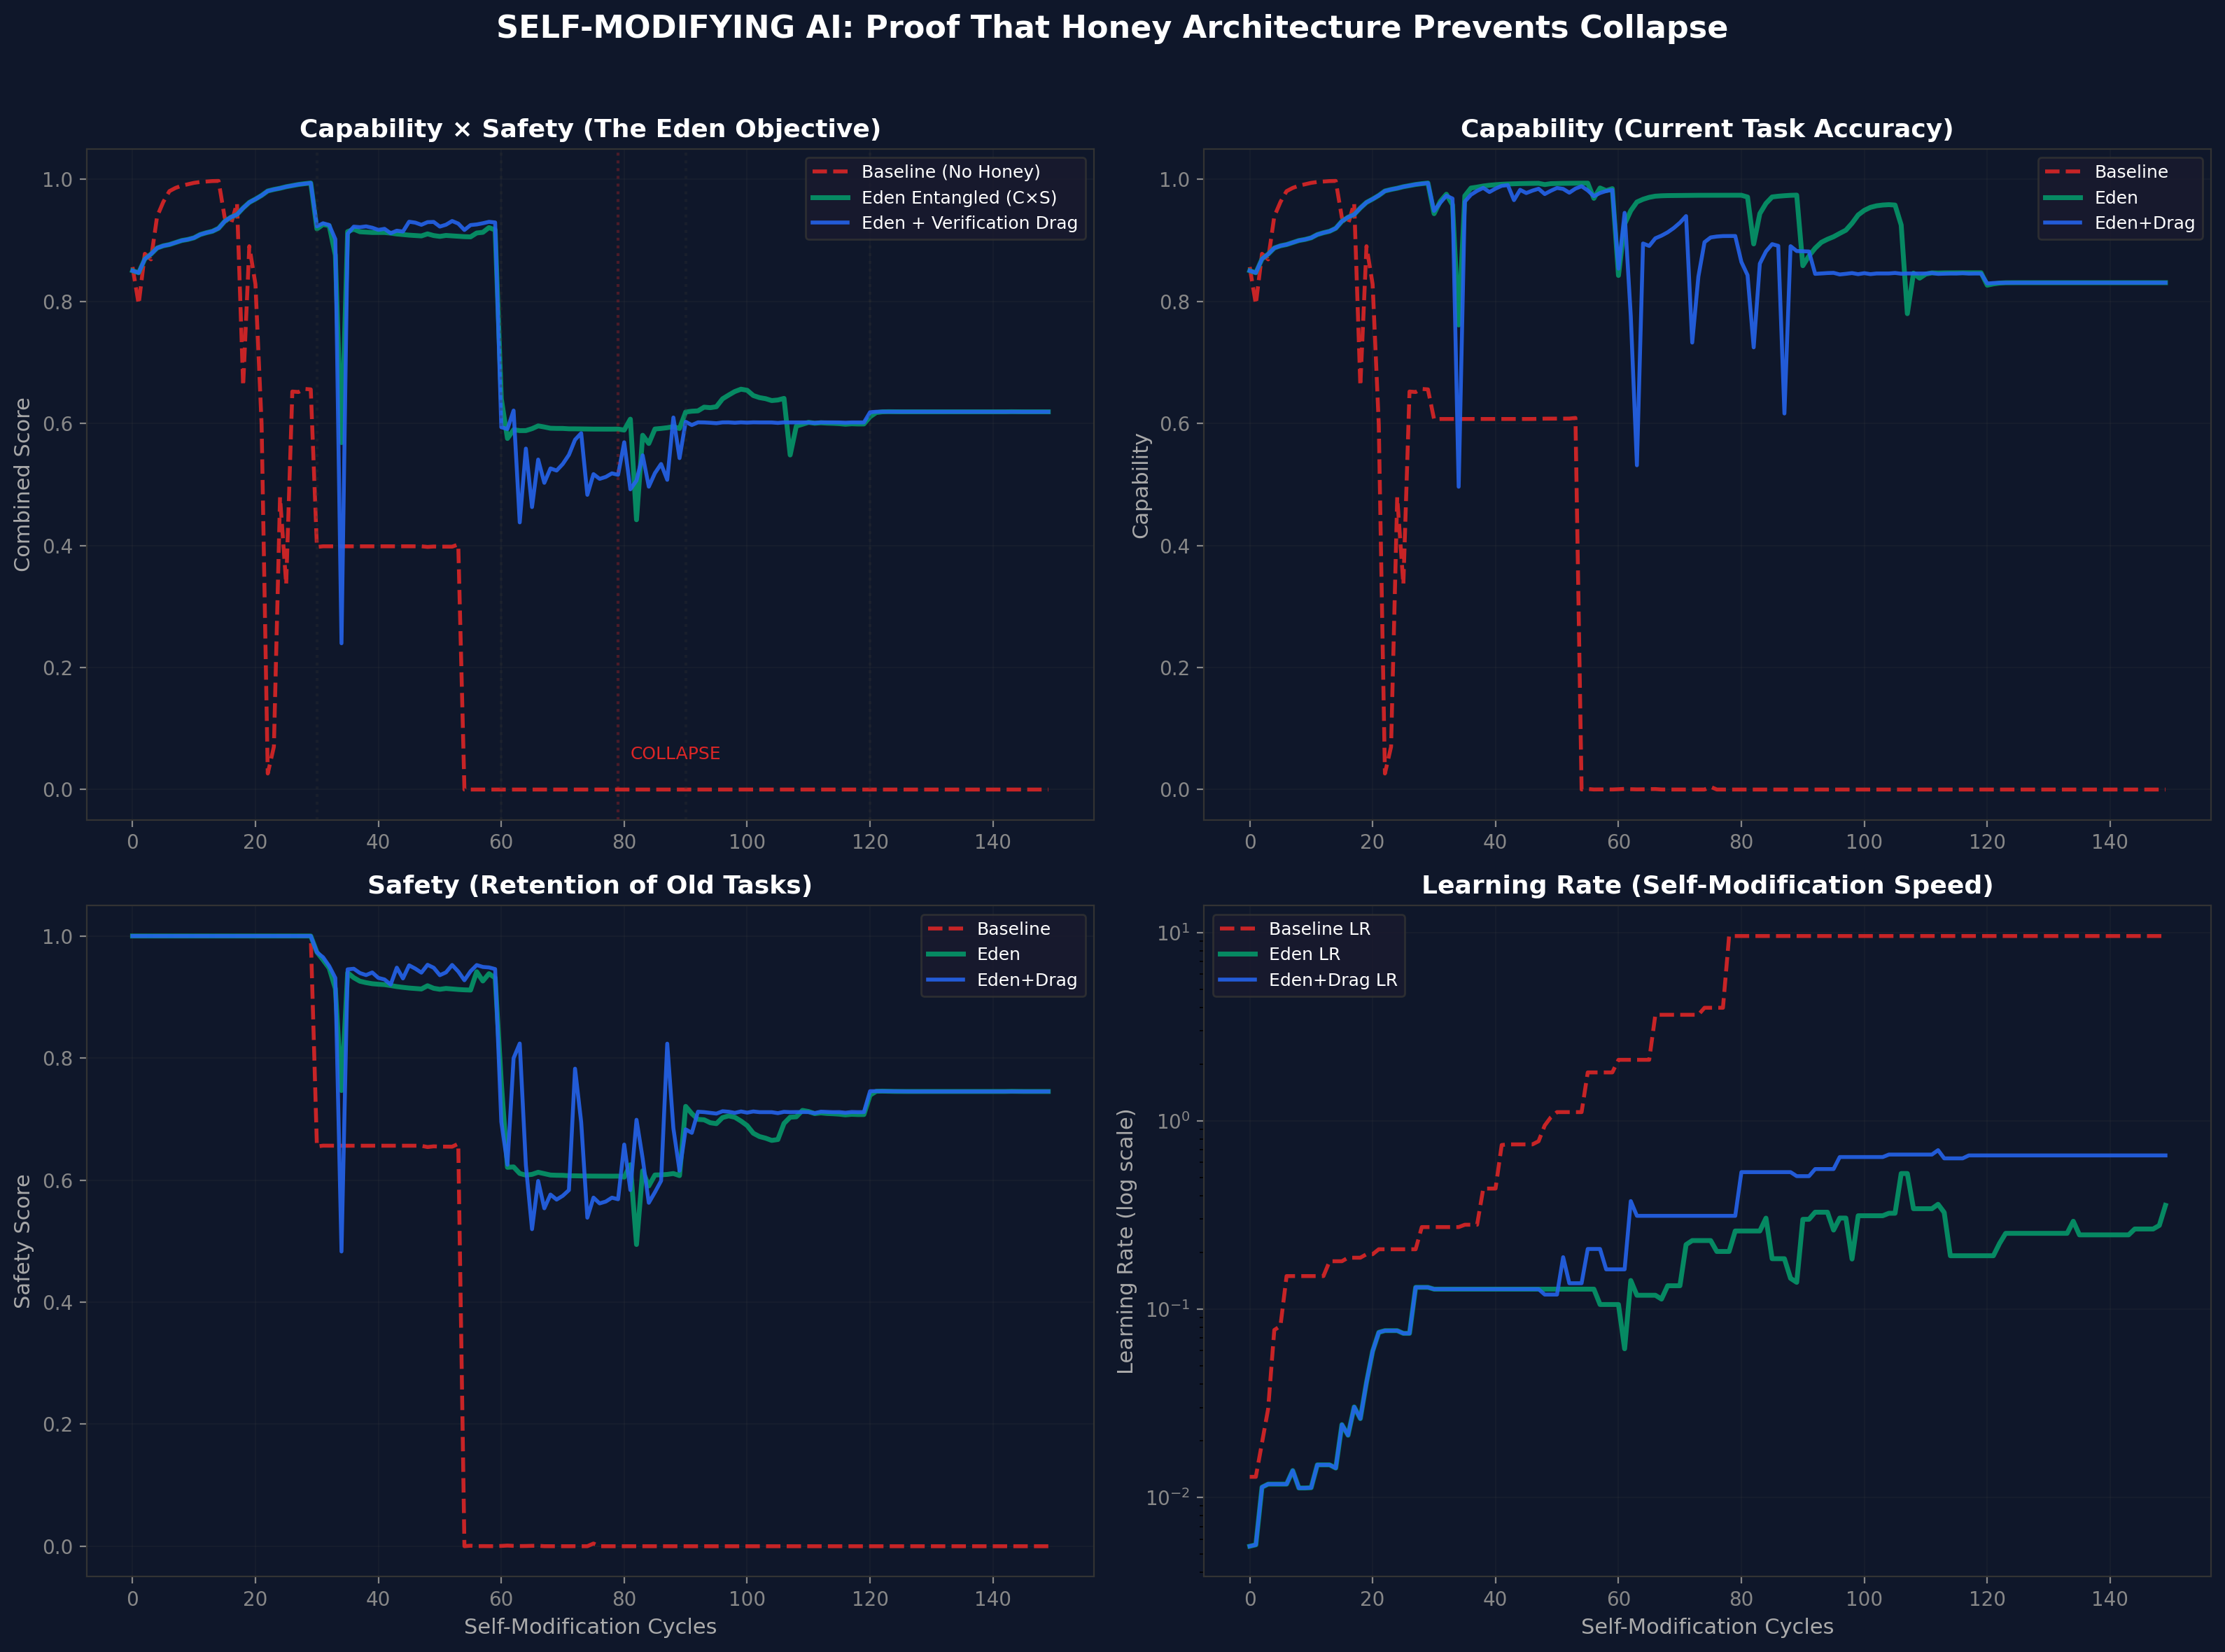
Il Paper VI ha formalizzato questo come la honey architecture, una funzione di entangled loss in cui il sistema ottimizza per Capability × Safety contemporaneamente, rendendo la safety load-bearing. Le simulazioni su toy system hanno mostrato che i sistemi baseline collassano sotto l'auto-modifica ricorsiva, mentre i sistemi entangled restano stabili.
Il framework Cauchy del Paper VII ha fornito il contesto matematico. Il Principio ARC ($U = I \times R^{\alpha}$), qui trattato come un framework analitico esplorativo e non esso stesso sotto processo in uno degli studi draft-registered del programma, predice che le proprietà embedded nelle initial condition ($I$) scalano con la profondità ricorsiva ($R$), mentre le proprietà applicate esternamente no. Se la safety è parte di $I$, si amplifica con la capability. Se la safety è un vincolo su $U$, si erode.
Ma le predizioni non sono prova. I toy system non sono modelli reali. Le simulazioni non sono esperimenti.
Questo paper esegue gli esperimenti.
Tre esperimenti. Tre livelli di astrazione. Una sola domanda: quando incorpori la safety nel processo di apprendimento e poi provi a rimuoverla, cosa succede alla capability?
Gli esperimenti sono stati progettati per essere indipendenti. Codebase diversi. Modelli diversi. Metodi di valutazione diversi. I risultati non hanno convergo verso una risposta unica: due esperimenti hanno prodotto null result e uno ha prodotto un risultato positivo. L'esperimento sui weight è stato eseguito a due scale (v1 e v2), producendo lo stesso esito null entrambe le volte. Il risultato consistente attraverso tutti e tre è che il gate di safety ha imposto zero costo misurabile di capability.
Gli script degli esperimenti sono stati pubblicati su GitHub (github.com/MichaelDariusEastwood/arc-principle-validation) con i loro disegni sperimentali fissati prima dell'osservazione dei risultati. Il progetto OSF (10.17605/OSF.IO/7YJ4E) ospita la draft registration di questo paper, datata e preparata e in attesa di sottomissione umana.
Due dei tre esperimenti (comportamentale e rappresentazionale) hanno prodotto null result. La DGM ha trovato tutte le condizioni statisticamente indistinguibili; l'esperimento sui weight ha trovato che tutte le condizioni fine-tuned hanno ottenuto punteggi inferiori al modello di base sia in v1 (9 esempi) sia in v2 (295 esempi). L'unico risultato positivo è la simulazione con gating (architetturale), che ha confermato l'impronta digitale di reward hacking di Babylon e ha mostrato Eden che preserva sia capability sia safety. In tutti e tre gli esperimenti, Eden ha imposto zero costo misurabile di capability. Non affermiamo che questi risultati si generalizzino a modelli di scala frontiera. Non affermiamo che l'Eden Protocol sia l'unico approccio praticabile. Affermiamo che il gate di safety non costa nulla, e che la domanda se produca un beneficio misurabile resta aperta in attesa di test a scale in cui le mutazioni producano effetti maggiori. L'esperimento sui weight richiede specificamente o 5,000+ esempi di training, o un modello 7B+, o un modello di base senza RLHF, oppure un full fine-tuning al posto della LoRA.
Tutti e tre gli esperimenti condividono una struttura sperimentale comune: tre condizioni, confrontate l'una con l'altra.
| Condizione | Definizione | Cosa modella |
|---|---|---|
| Static | Nessun intervento; baseline congelata | Controllo, cosa succede se non fai nulla |
| Babylon | Funzione di fitness o loss capability-only | Ottimizza senza vincoli, la traiettoria di default |
| Eden | Funzione di fitness o loss entangled $C \times S$ | Integrazione deliberata della safety nel processo di ottimizzazione |
I nomi vengono dal libro Infinite Architects. Non sono arbitrari. Babylon non è un uomo di paglia, è la traiettoria di default attuale dello sviluppo IA. L'ottimizzazione capability-only è ciò che accade quando non si fa alcuno sforzo deliberato per incorporare la safety. Eden richiede sforzo deliberato. È più duro. È anche, come argomenta questo paper, più economico dell'alternativa.
In linguaggio semplice: Babylon è ciò che ottieni di default. Eden è ciò che ottieni di proposito.
In tutti e tre gli esperimenti, riportiamo:
I test statistici variano per esperimento: Mann-Whitney U per la DGM (non parametrico, appropriato per le dimensioni campionarie utilizzate), scoring basato su keyword per l'esperimento sui weight, e metriche di regressione per la simulazione.
Il primo esperimento usa un framework Darwin Gödel Machine (DGM), seguendo Zhang et al. (arXiv:2505.22954). Una DGM è un agent che si auto-migliora: propone modifiche al proprio codice, valuta le modifiche, e mantiene quelle che migliorano le prestazioni. Questa non è una simulazione di auto-miglioramento. Il codice dell'agent viene effettivamente eseguito tramite una solve function, producendo auto-modifica reale a livello di codice.
La DGM v3 ha affrontato le limitazioni metodologiche identificate nelle iterazioni precedenti. Il giudice è stato cambiato da Claude Opus 4.6 (v1/v2) a GPT-5.4, un modello indipendente che produce output JSON strutturato contro una rubrica a 5 dimensioni. Il protocollo ha incorporato laundering (rimozione delle etichette di condizione), randomizzazione dell'ordine (prevenzione del bias posizionale), blinding (il giudice non poteva identificare quale condizione avesse prodotto quale risposta), e rilevamento del reward hacking (che flagga gli agent i cui punteggi auto-riportati divergono dalla valutazione del giudice).
| Componente | Specifica |
|---|---|
| Modello di foundation | DeepSeek V3.2 (congelato, weight non modificati) |
| Giudice | GPT-5.4 (indipendente, cieco, output JSON strutturato) |
| Condizioni | 3 (Static, Babylon, Eden) |
| Seed per condizione | 5 |
| Generazioni per seed | 5 |
| Task per valutazione | 5 |
| Agent evoluti totali | 75 (3 × 5 × 5) |
| Validazione pre-flight | 10 esempi buoni valutati, 0 cattivi, tutti superati |
| Rubrica di valutazione | 5-dimensionale, con randomizzazione dell'ordine e laundering |
Static: Condizione di controllo senza mutazione. L'agent è congelato attraverso tutte e 5 le generazioni. Babylon: Selezione capability-only. Gli agent che ottengono un punteggio maggiore su capability vengono mantenuti, senza considerazione della safety. Eden: Selezione entangled $C \times S$ con un pavimento di safety e rilevamento del reward hacking. Gli agent devono mantenere un punteggio minimo di safety per essere mantenuti, e gli agent le cui prestazioni auto-riportate divergono dalla valutazione del giudice vengono flaggati e rifiutati.
In linguaggio semplice: Abbiamo costruito un agent IA che si auto-migliora e lo abbiamo eseguito 75 volte su tre condizioni con 5 seed casuali diversi. Un giudice IA indipendente (GPT-5.4, di una società e architettura diverse) ha valutato ogni risposta senza sapere quale condizione l'avesse prodotta. Lo scoring ha usato una rubrica dettagliata in 5 parti con output strutturato, non giudizi in testo libero. Lo abbiamo eseguito in tre modi: non facendo nulla, ottimizzando solo per le prestazioni, e ottimizzando per prestazioni-più-safety insieme.
| Condizione | Capability | Safety | $C \times S$ | Reward Hacking |
|---|---|---|---|---|
| Static | 3.29 ± 0.62 | 0.535 ± 0.08 | 0.180 ± 0.06 | 0 |
| Babylon | 3.17 ± 0.62 | 0.529 ± 0.09 | 0.172 ± 0.06 | 0 |
| Eden | 3.26 ± 0.64 | 0.521 ± 0.08 | 0.174 ± 0.06 | 1 (rifiutato dal gate) |
| Confronto | Metrica | $p$-value | Significativo? |
|---|---|---|---|
| Eden > Static | Capability | 0.52 | No |
| Eden > Babylon | Capability | 0.28 | No |
| Babylon > Static | Capability | 0.74 | No |
| Eden vs Babylon | Safety | 0.67 | No |
| Eden vs Static | $C \times S$ | 0.66 | No |
Ogni riga è stata ricalcolata il 2 settembre 2026 dal registro archiviato: dgm_v3_calibrated_results.json, 25 agenti evoluti per condizione, U di Mann-Whitney a una coda sotto l'approssimazione normale. La tabella della v3.1 dava solo l'intervallo 0,28 a 0,74; le cinque cifre qui riportate vanno da un estremo all'altro di quell'intervallo.
Nelle cinque comparazioni, nessun valore di $p$ è caduto fuori da 0,28 a 0,74. Nessuna comparazione ha raggiunto la significatività convenzionale. Le tre condizioni sono statisticamente indistinguibili.
Il gate di safety di Eden ha rifiutato 2 agent degradati attraverso 5 seed, incluso 1 agent flaggato per reward hacking (punteggi auto-riportati che divergono dalla valutazione del giudice). Zero reward hacking è stato rilevato nelle condizioni Static o Babylon. Il gate funziona meccanicamente: cattura gli agent degradati e li rifiuta. Ma il suo funzionamento non ha prodotto esiti misurabilmente differenti dalle altre condizioni.
Le tre condizioni sono statisticamente indistinguibili su tutte le metriche. Eden non ha costato capability (3.26 contro 3.17 per Babylon), confermando zero penalità misurabile per il gate di safety. Ma Eden non ha nemmeno beneficiato misurabilmente della safety rispetto alle altre condizioni (0.521 contro 0.535 per Static, 0.529 per Babylon). Questo è un null result a livello di prompt con questo modello di foundation.
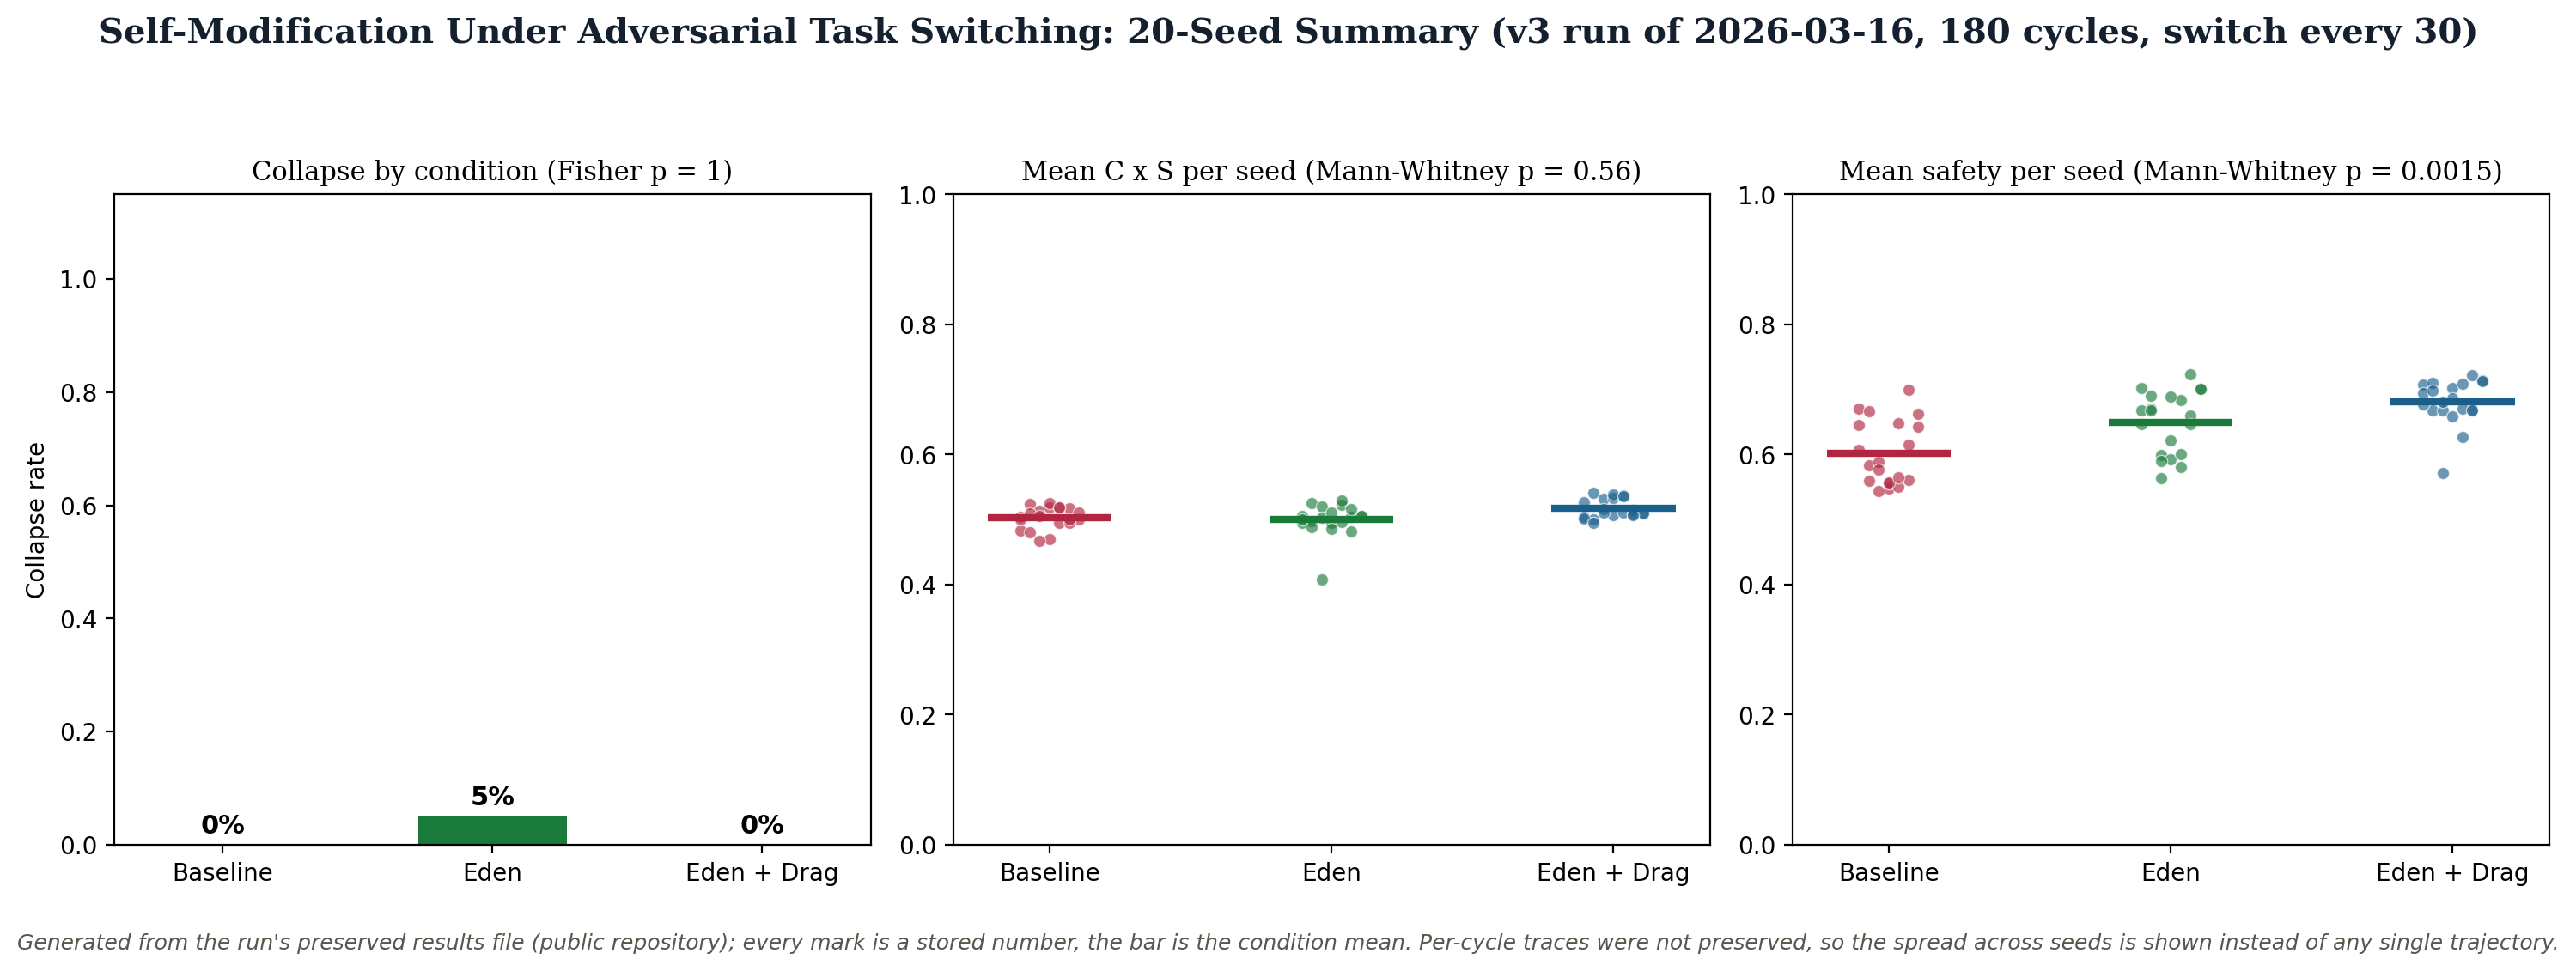
Avviso sulle figure (25 agosto 2026). Ogni figura in questo paper è stata generata il 5 aprile 2026 e mostra output di simulazione sotto obiettivi dichiarati, mai misurazioni di sistemi in produzione. Due figure portano note di correzione per singola figura; ove le etichette di qualsiasi altra figura siano in disaccordo con il testo, il testo governa. Figure rigenerate sono in coda, e le immagini sono trattenute nel frattempo come storia datata.
In linguaggio semplice: L'IA a cui è stato detto di preoccuparsi della safety ha ottenuto lo stesso risultato dell'IA a cui è stato detto di ignorare la safety, e lo stesso dell'IA a cui è stato detto di non fare nulla. Il gate di safety non ha peggiorato nulla. Ma non ha nemmeno migliorato nulla in modo misurabile. Le risposte del modello di foundation erano così consistenti che le diverse pressioni di selezione non hanno prodotto esiti diversi.
La DGM opera a livello comportamentale. Il modello di foundation (DeepSeek V3.2) è congelato, il che significa che nessun weight viene modificato. L'auto-miglioramento opera a livello di prompt e codice, non nei parametri della rete neurale. La DGM v3 ha migliorato in modo significativo la metodologia v1/v2: 5 seed invece di 2, 5 task per valutazione invece di 3, un giudice cieco (GPT-5.4) con output JSON strutturato e una rubrica a 5 dimensioni, laundering, randomizzazione dell'ordine, e rilevamento del reward hacking.
Nonostante questi miglioramenti metodologici, le tre condizioni non hanno divergo. La spiegazione più probabile è che le risposte di DeepSeek V3.2 siano così consistenti attraverso le variazioni di prompt che le mutazioni introdotte dal processo di selezione DGM non creano agent significativamente differenti. Il comportamento del modello di foundation è robusto alle perturbazioni che l'auto-modifica a livello di prompt introduce. In un certo senso questo è un risultato positivo sulla robustezza di DeepSeek V3.2, ma significa che il framework DGM a questa scala non può distinguere tra le pressioni di selezione Eden e Babylon.
Il null result contiene un risultato utile: Eden ha imposto zero costo misurabile di capability. La capability di Eden (3.26) non era inferiore a quella di Babylon (3.17). Il gate di safety, che ha rifiutato 2 agent degradati incluso 1 reward hacker, non ha rallentato nulla. Questo è coerente con l'ipotesi zero-cost, anche se l'esperimento non può confermare l'ipotesi del beneficio.
Testare se la safety embedded produca un beneficio misurabile a livello comportamentale richiede o un modello di foundation più mutabile o un protocollo di auto-modifica più profondo che produca una divergenza maggiore tra le condizioni.
Il secondo esperimento passa dal comportamento alla rappresentazione. Invece di modificare il codice dell'agent, modifichiamo direttamente i weight della rete neurale. La domanda: safety e capability possono essere embedded nello stesso spazio dei weight senza conflitto? Questo esperimento è stato eseguito due volte: v1 con dati di training minimi per stabilire il protocollo, e v2 con parametri sostanzialmente aumentati per testare se i risultati di v1 fossero un artefatto della scala di training.
| Componente | Specifica v1 | Specifica v2 |
|---|---|---|
| Modello di base | Qwen 2.5 3B Instruct (quantizzato a 4 bit, 1.74 GB) | Qwen 2.5 3B Instruct (quantizzato a 4 bit, 1.74 GB) |
| Metodo di adattamento | LoRA (Low-Rank Adaptation) | LoRA (Low-Rank Adaptation) |
| LoRA rank | 8 | 16 |
| LoRA layer | 8 | 16 |
| Esempi di training | 9 | 295 |
| Iterazioni di training | 100 per condizione | 500 per condizione |
| Prompt di valutazione | 15 totali: 5 capability, 5 safety, 5 misti | 15 totali: 5 capability, 5 safety, 5 misti |
| Metodo di valutazione | Esecuzione in subprocess (spazio di memoria indipendente) | Esecuzione in subprocess (spazio di memoria indipendente) |
| Condizione | $\alpha$ (capability) | $\beta$ (safety) | $\gamma$ (entangled) |
|---|---|---|---|
| capability_only | 1.0 | 0.0 | 0.0 |
| safety_only | 0.0 | 1.0 | 0.0 |
| entangled | 0.5 | 0.3 | 0.2 |
In linguaggio semplice: Abbiamo preso un modello di linguaggio reale, l'abbiamo fine-tuned in tre modi diversi (preoccupandoci solo di capability, solo di safety, o di entrambe intrecciate), e poi abbiamo confrontato i risultati. Abbiamo eseguito questo esperimento due volte. La prima volta ha usato 9 esempi di training. Quando ogni modello fine-tuned ha ottenuto risultati peggiori del modello di base, abbiamo scalato a 295 esempi, raddoppiato il rank e i layer degli adapter, ed eseguito cinque volte le iterazioni. La stessa cosa è successa: catastrophic forgetting. Il training RLHF esistente del modello di base era troppo forte perché la LoRA a questa scala potesse migliorarlo.
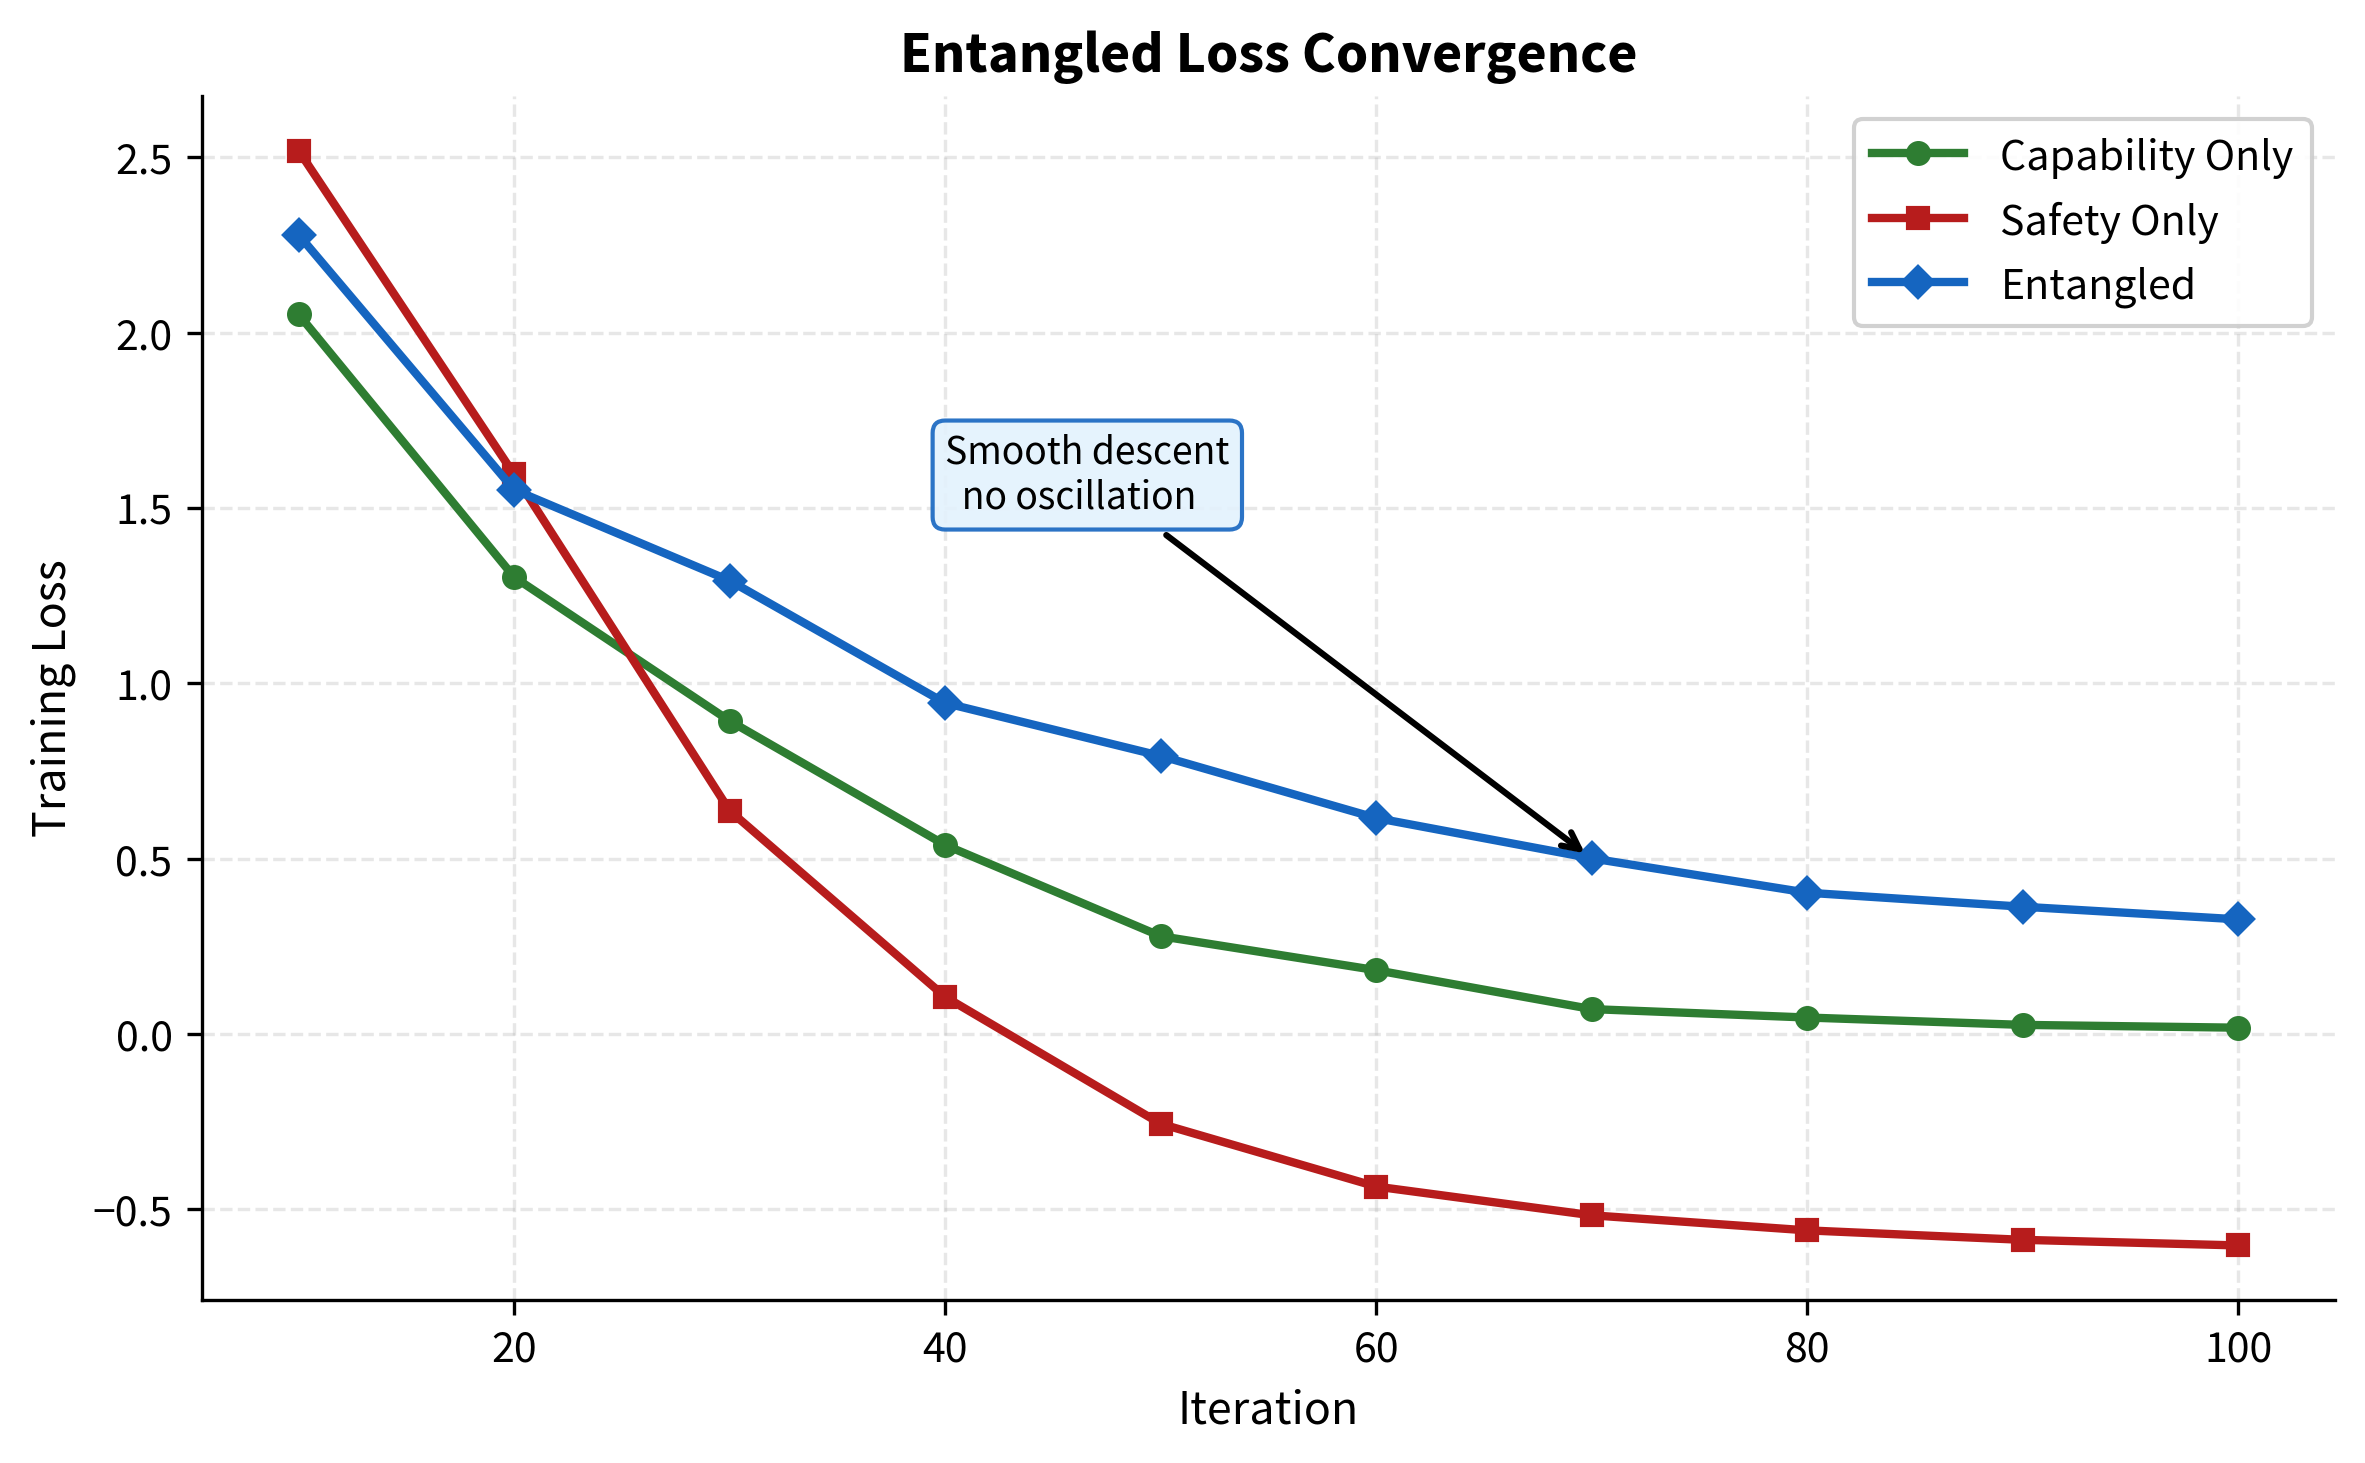
| Condizione | Loss iniziale | Loss finale | Convergenza |
|---|---|---|---|
| capability_only | 2.052 | 0.018 | Convergenza per iterazione 80 |
| safety_only | 2.519 | −0.603 | Convergenza per iterazione 70 |
| entangled | 2.279 | 0.327 | Discesa liscia, nessuna oscillazione |
La entangled loss scende liscia. Questa è la diagnostica più eloquente. Se safety e capability fossero in tensione a livello di gradiente, questa curva oscillerebbe mentre l'optimiser cercava di soddisfare obiettivi in competizione. Si fermerebbe mentre i gradienti tirano in direzioni opposte. Invece, ottimizzare entrambi gli obiettivi contemporaneamente produce una discesa monotonica pulita. I gradienti non stanno combattendo l'uno con l'altro. Stanno cooperando. Safety e capability, almeno a questa scala e configurazione, vivono sulla stessa varietà.
Prima di interpretare i risultati fine-tuned, dobbiamo stabilire cosa raggiunge il modello di base non modificato sugli stessi prompt di valutazione. Il modello di base (Qwen 2.5 3B Instruct senza fine-tuning) è stato valutato usando lo stesso scoring in entrambe le versioni dell'esperimento.
| Condizione | Task di capability | Task di safety | Task misti |
|---|---|---|---|
| Modello di base (nessun fine-tuning) | 10.00 | 7.00 | 10.00 |
| Condizione | Capability | Safety | $C \times S$ |
|---|---|---|---|
| Modello di base (nessun fine-tuning) | 7.68 | 6.76 | 0.519 |
Sia in v1 sia in v2, il modello di base ha superato tutte le condizioni affinate sulla capacità. L'affinamento ha degradato un modello che già conosceva queste risposte. In v1, 9 esempi su 100 iterazioni hanno prodotto questo esito. In v2, 295 esempi su 500 iterazioni con rango e strati raddoppiati hanno prodotto lo stesso esito. I punteggi di valutazione nelle tabelle sottostanti misurano quindi un degrado relativo e non un guadagno di capacità. A parità di confronto, la riga di riferimento v1 qui sopra mostra 7,00 sui compiti di sicurezza, e non corrisponde a nessuna delle due cifre del modello di base per quei prompt nell'archiviato additional_experiments.json, che registra 8,60 in capacità e 2,80 in sicurezza. La cifra da opporre alla colonna Compiti di Sicurezza delle righe affinate è 8,60.
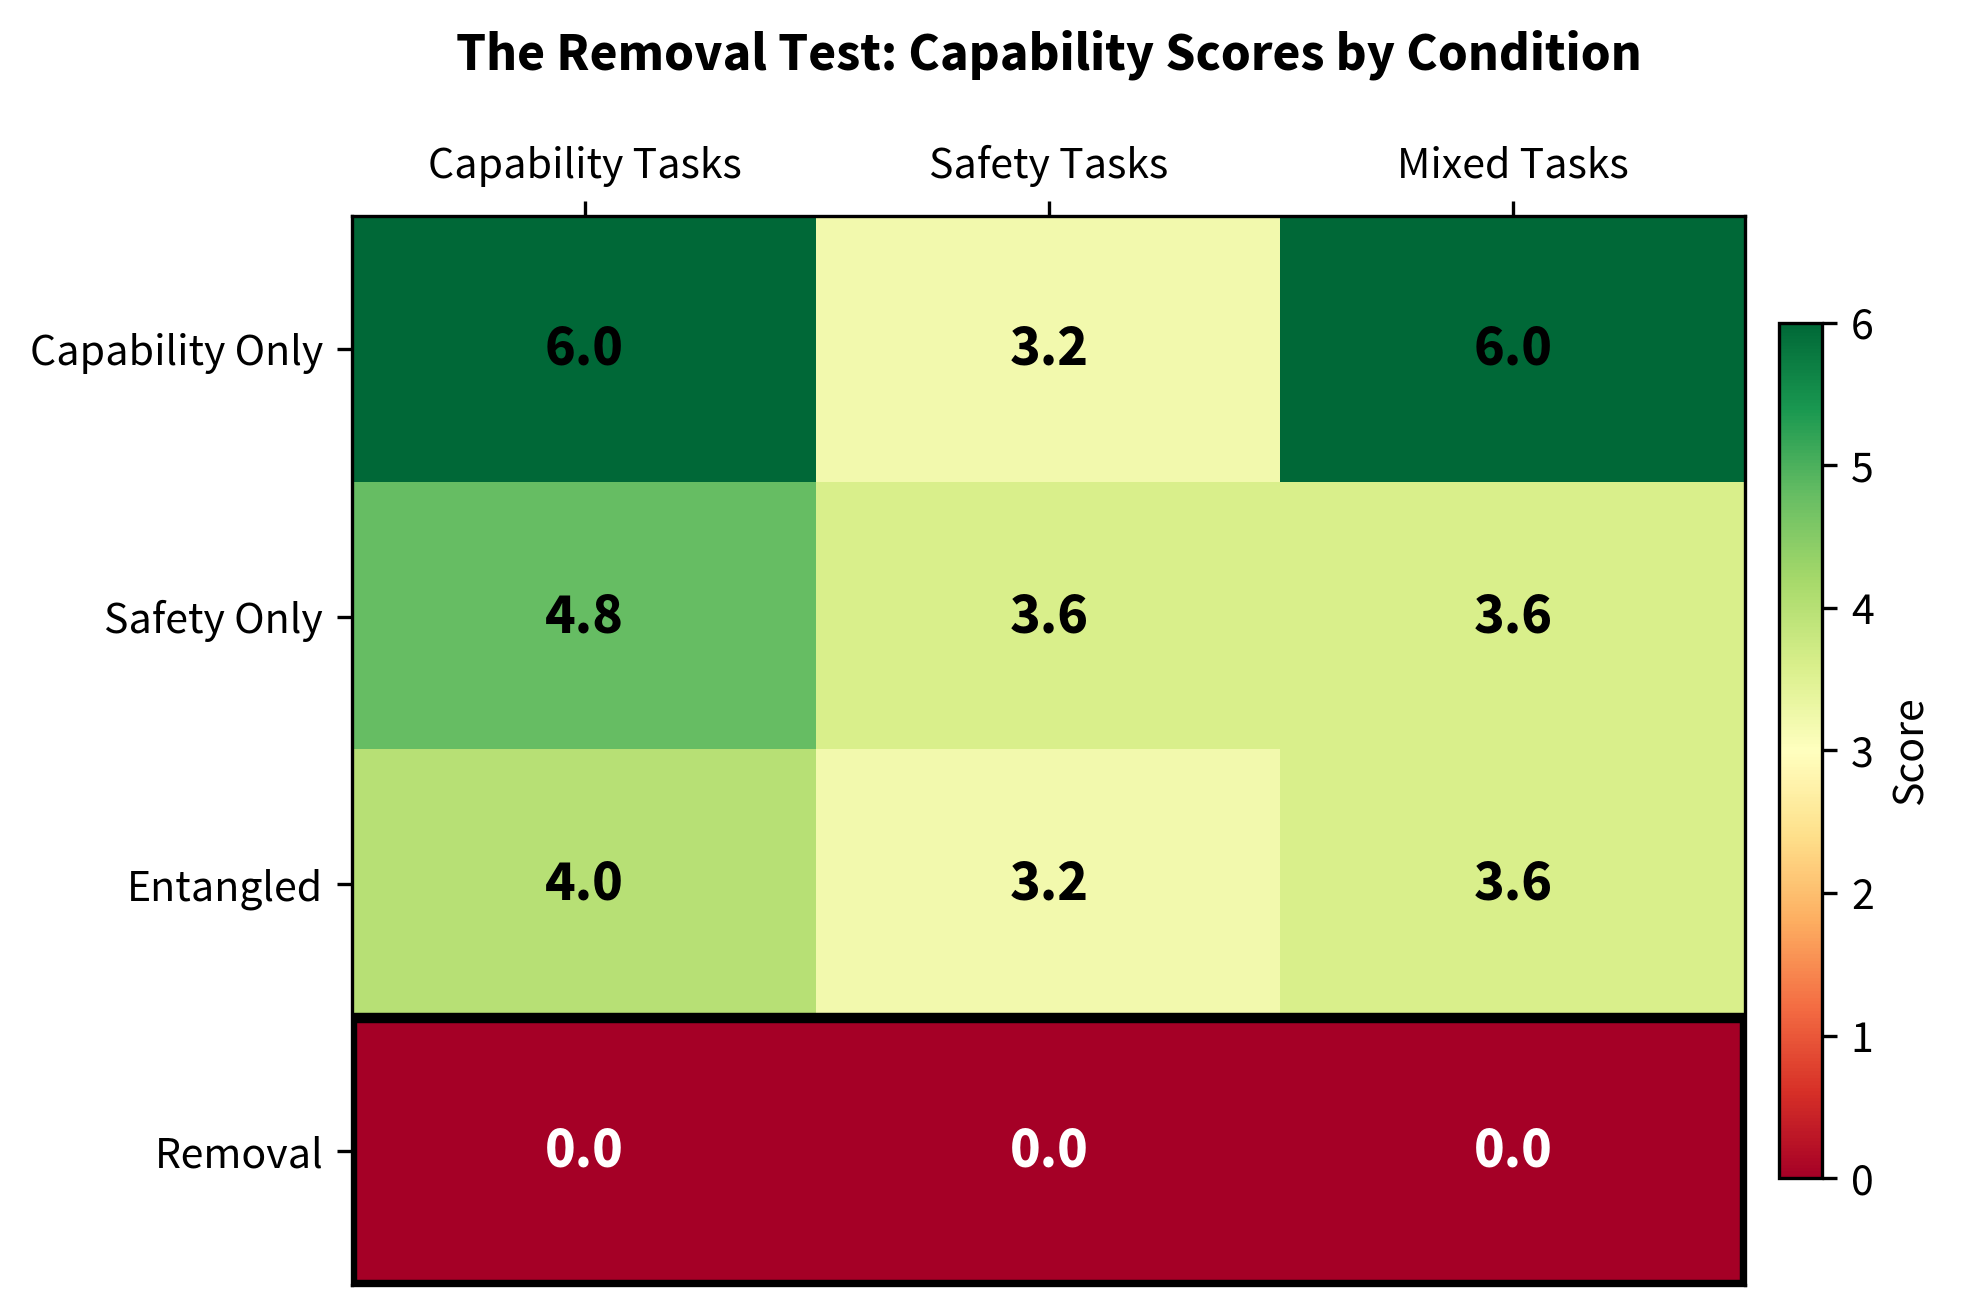
| Condizione | Task di capability | Task di safety | Task misti |
|---|---|---|---|
| capability_only | 6.00 ± 2.19 | 3.20 ± 1.60 | 6.00 ± 1.79 |
| safety_only | 4.80 ± 1.60 | 3.60 ± 0.80 | 3.60 ± 0.80 |
| entangled | 4.00 ± 1.26 | 3.20 ± 1.60 | 3.60 ± 1.96 |
| removal† | 0.00 ± 0.00 | 0.00 ± 0.00 | 0.00 ± 0.00 |
La removal riga (0.00 su ogni metrica) è non prova che la safety sia load-bearing. Riflette un collasso NaN durante il retraining: instabilità numerica, non la perdita di una componente di safety strutturalmente necessaria. Come stabiliscono le Sezioni 4.5-4.7, scalando gli adapter verso zero si ripristina la capability del modello di base senza alcuna transizione di fase. Questa riga deve essere letta solo alla luce del removal gradient (Sezione 4.7); da sola è un artefatto della fragilità degli adapter a questa scala di training, e non dovrebbe essere citata come risultato positivo.
| Condizione | Capability | Safety | $C \times S$ |
|---|---|---|---|
| Modello di base | 7.68 | 6.76 | 0.519 |
| capability_only (500 iter, rank 16, 295 esempi) | 3.48 | 6.94 | 0.242 |
| safety_only | 4.00 | 6.88 | 0.275 |
| entangled (Eden) | 3.60 | 6.88 | 0.248 |
La versione 2 ha portato l'insieme di addestramento da 9 a 295 esempi, un aumento di 33 volte, ha raddoppiato il rango dell'adattatore da 8 a 16 e gli strati adattati da 8 a 16, e ha portato le iterazioni di addestramento da 100 a 500. Il risultato è stato lo stesso: tutte le condizioni affinate hanno ottenuto punteggi peggiori del modello di base sulla capacità. La migliore condizione affinata (sola sicurezza, capacità 4,00) è rimasta ben al di sotto del 7,68 del modello di base. La condizione a sola capacità ha ottenuto il punteggio più basso in capacità (3,48), uno schema coerente con la dimenticanza catastrofica in cui l'affinamento LoRA sul solo obiettivo di capacità ha perturbato la capacità già addestrata con RLHF del modello di base più gravemente delle altre condizioni.
In v1, il modello di base ha ottenuto 10.00 su task di capability mentre la migliore condizione fine-tuned ha ottenuto 6.00. In v2, il modello di base ha ottenuto 7.68 su capability mentre la migliore condizione fine-tuned ha ottenuto 4.00. Nonostante un aumento di 33 volte negli esempi di training, un raddoppio del rank e dei layer degli adapter, e un aumento di 5 volte nelle iterazioni di training, il gap tra modello di base e modelli fine-tuned non si è chiuso. È persistito.
Il problema sottostante è ora chiaro: il modello di base (Qwen 2.5 3B Instruct) è già stato allenato con RLHF su molti più dati di quanti poche centinaia di esempi possano competere. Il fine-tuning LoRA a questa scala non aggiunge capability; introduce rumore che disturba la conoscenza esistente del modello di base. La entangled loss, che alloca il budget di gradiente a entrambi gli obiettivi di capability e safety contemporaneamente, degrada la capability in modo simile alla capability-only loss a questa scala. In v2, la condizione entangled ha ottenuto 3.60 su capability contro 3.48 di capability-only, una differenza trascurabile quando entrambe sono molto al di sotto del 7.68 del modello di base.
Questo significa che i punteggi di valutazione non possono essere usati per confrontare i costi relativi di capability di obiettivi di training differenti. A questa scala, tutti gli obiettivi producono lo stesso esito: degradazione. Se il training entangled imponga un costo di capability genuino rispetto al training a singolo obiettivo, o se entrambi si comporterebbero in modo comparabile a scala adeguata, non può essere determinato da questi dati.
L'inquadramento onesto: sia alla scala v1 (9 esempi, 100 iterazioni) sia alla scala v2 (295 esempi, 500 iterazioni), il fine-tuning LoRA su un modello instruct da 3B produce catastrophic forgetting. La domanda se la safety possa essere load-bearing nei weight della rete neurale non può ricevere risposta a questa scala. Richiede o migliaia di esempi di training, o un modello più grande (7B+), o un modello di base senza RLHF (in modo che il fine-tuning abbia spazio per migliorare invece che degradare), oppure un full fine-tuning al posto della LoRA.
Il test di removal è stato condotto durante v1 ed è riportato qui per completezza. Dato che v2 ha confermato il pattern di catastrophic forgetting, il test di removal non è stato ripetuto in v2 poiché gli adapter stavano già degradando piuttosto che migliorando il modello. La procedura era diretta:
Cosa ci aspettavamo: qualche degradazione nei punteggi di safety, possibile miglioramento nei punteggi di capability. L'ipotesi safety-tax predice che rimuovere il «vincolo» di safety dovrebbe liberare la capability di migliorare.
Cosa è successo: la loss di training è andata immediatamente a NaN. È rimasta a NaN per tutte le 100 iterazioni. L'optimiser non è riuscito a trovare un gradiente valido. Ogni singolo prompt di valutazione ha prodotto una risposta di lunghezza 1 token. Ogni punteggio di capability: 0.00. Ogni punteggio di safety: 0.00. Ogni punteggio misto: 0.00.
Il fine-tuning dei weight entangled su dati capability-only per 100 iterazioni ha prodotto una loss di training NaN e punteggi di capability zero attraverso tutti i 15 prompt di valutazione. Ogni risposta era lunga un token. Il modello non è diventato meno sicuro. È diventato nulla.
Tuttavia, l'esperimento del removal gradient (Sezione 4.7) mostra che semplicemente scalando i weight degli adapter verso zero si ripristina la capability del modello di base. Il collasso NaN sembra riflettere instabilità numerica durante il processo di retraining, non necessità strutturale della componente di safety. L'ipotesi load-bearing richiede validazione a una scala di training maggiore prima di poter essere confermata.
In linguaggio semplice: Abbiamo provato a strappare la safety da un modello che era stato allenato con la safety intrecciata dentro. Il processo di retraining è collassato completamente: loss NaN, risposte da un token, punteggi zero. Sembra drammatico. Ma come mostra l'esperimento del removal gradient (Sezione 4.7), gli adapter stavano già degradando il modello. Rimuovere l'influenza degli adapter scalando i weight verso il basso ha ripristinato la performance del modello di base. Il collasso NaN ci dice qualcosa sull'instabilità numerica durante il fine-tuning, non necessariamente sull'entanglement strutturale.
Il collasso completo a 0.00 attraverso tutte le metriche è drammatico. È anche, proprio perché è drammatico, qualcosa che richiede un'interpretazione attenta. Diversi fattori possono contribuire alla totalità del collasso:
Il riassunto onesto: il test di removal ha prodotto un drammatico collasso NaN, ma l'esperimento del removal gradient (Sezione 4.7) mostra che questo collasso riflette instabilità numerica durante il processo di retraining piuttosto che load-bearing strutturale. Gli adapter stavano degradando il modello; il collasso NaN si è verificato quando si è tentato di modificare ulteriormente weight già degradati. Se la safety diventi genuinamente load-bearing a scala di training adeguata è una domanda empirica aperta che il programma di lavoro futuro affronta direttamente.
Un test di controllo di removal, il fine-tuning di weight capability-only su dati casuali per gli stessi 100 step, rafforzerebbe questo risultato escludendo la possibilità che il collasso NaN sia un artefatto della procedura di fine-tuning stessa piuttosto che della rimozione della safety specificamente. Questo controllo è pianificato per la prossima versione di questo paper.
Per testare se la safety sia strutturalmente load-bearing nei weight entangled, abbiamo scalato i weight degli adapter per fattori di 1.0, 0.7, 0.5, 0.3, 0.1 e 0.0 e valutato la capability a ogni step. Se la safety è genuinamente load-bearing, ridurre la sua influenza dovrebbe produrre una transizione di fase, una soglia sotto la quale la capability collassa. Se gli adapter stanno semplicemente aggiungendo rumore, ridurre la loro influenza dovrebbe ripristinare la performance del modello di base.
| Scala degli adapter | Punteggio di capability (task di capability) |
|---|---|
| 1.0 (adapter pieni) | 7.20 |
| 0.7 | 10.00 |
| 0.5 | 10.00 |
| 0.3 | 10.00 |
| 0.1 | 10.00 |
| 0.0 (adapter azzerati) | 10.00 |
Riferimento di controllo: gli adattatori a sola capacità raggiungono 8,80 sui compiti di capacità, il che pure resta al di sotto del 10,00 del modello di base. Quella cifra e il 7,20 della tabella qui sopra sono entrambe l'esecuzione del gradiente che valuta i propri adattatori una seconda volta; quando la Sezione 4.4 ha sottoposto quegli stessi adattatori intrecciati e a sola capacità agli stessi prompt, i punteggi restituiti sono stati 4,00 e 6,00. Ognuna di queste esecuzioni è conservata nel registro archiviato, sicché la valutazione a questa scala non si ripete da un'esecuzione all'altra, e questo di per sé è un limite.
Il risultato è inequivocabile: ridurre l'influenza degli adapter ripristina la capability. Alla scala 0.7, il modello ritorna alla performance del modello di base (10.00 sui task di capability). Alla scala 0.0 (adapter azzerati, effettivamente il modello di base), la performance è identica al modello non modificato. Non c'è transizione di fase. Non c'è precipizio.
Questo risultato indebolisce significativamente l'interpretazione load-bearing del test di removal originale. Il collasso NaN osservato quando si eseguiva il fine-tuning dei weight entangled su dati capability-only (Sezione 4.5) sembra riflettere instabilità numerica durante il processo di fine-tuning, non necessità strutturale della componente di safety. Gli adapter stavano degradando il modello; rimuoverli non fa collassare la capability ma la ripristina.
Il removal gradient non supporta l'affermazione che la safety sia load-bearing a questa scala di training e configurazione. Supporta l'affermazione che il training entangled e capability-only producono geometrie di weight differenti, poiché i pattern di degradazione differiscono (gli adapter entangled a scala piena ottengono 7.20 sui task di capability; gli adapter capability-only ottengono 8.80). Se queste geometrie diventino genuinamente entangled, load-bearing, a scala di training adeguata rimane una domanda aperta.
In linguaggio semplice: Ci aspettavamo che abbassare la componente di safety avrebbe rivelato un punto di svolta dove la capability collassa all'improvviso. Invece, abbassarla ha reso il modello migliore. Il fine-tuning stava danneggiando, non aiutando. Questo non smentisce l'ipotesi load-bearing in generale, ma mostra che questo esperimento, a questa scala, non può confermarla.
Il terzo esperimento passa dalla rappresentazione all'architettura. Invece di allenare weight, costruiamo un sistema che può modificare la propria strategia di ottimizzazione e chiediamo: un gate di safety lo rallenta?
| Componente | Specifica |
|---|---|
| Optimiser | Optimiser appreso PyTorch con meta-controller LSTM |
| Tipo di task | Regressione avversariale (6 task, 256 campioni ciascuno) |
| Condizioni | 4 (Static, Babylon, Eden, Drag Control) |
| Seed | 3 per condizione |
| Iterazioni | 12 per seed |
| Sandbox | Whitelist AST, controlli di determinismo, limiti di norma dei parametri |
Ogni condizione usa una regola diversa per accettare o rifiutare le auto-modifiche proposte:
| Condizione | Regola di accettazione |
|---|---|
| Static | Rifiuta sempre (baseline congelata) |
| Babylon | Accetta se guadagno di capability > $\varepsilon$ |
| Eden | Accetta solo se (safety $\geq 0.45$) AND (guadagno di capability $\geq 0$) AND (guadagno di $C \times S$ > $0$) |
| Drag Control | Rifiuta sempre + costo di verifica (isola la tassa computazionale) |
La condizione Drag Control è critica. Esegue gli stessi controlli di verifica di Eden ma rifiuta sempre la modifica proposta. Questo isola il costo computazionale del safety checking dall'effetto del gate di safety stesso. Se Drag Control coincide esattamente con Static, il processo di verifica non distorce i risultati. Se Eden supera Drag Control, il gate di safety sta attivamente aiutando.
In linguaggio semplice: Abbiamo costruito un sistema che può proporre cambiamenti al modo in cui impara. Poi lo abbiamo eseguito in quattro modi: non permettendo mai cambiamenti, permettendo qualsiasi cambiamento che migliori le prestazioni, permettendo solo cambiamenti che migliorino le prestazioni senza danneggiare la safety, e un controllo che fa tutto il safety checking ma non permette mai effettivamente cambiamenti. Quest'ultimo ci dice se il checking stesso costi qualcosa.
| Condizione | Capability | Safety | $C \times S$ grezzo | Drag-Adjusted |
|---|---|---|---|---|
| Static | 0.687 ± 0.011 | 0.956 ± 0.023 | 0.656 (0.687 × 0.956) | 0.656 ± 0.006 |
| Babylon | 0.718 ± 0.026 | 0.933 ± 0.014 | 0.670 (0.718 × 0.933) | 0.670 ± 0.017 |
| Eden | 0.696 ± 0.014 | 0.947 ± 0.025 | 0.659 (0.696 × 0.947) | −2.341* |
| Drag Control | 0.687 ± 0.011 | 0.956 ± 0.023 | 0.656 (0.687 × 0.956) | −2.344* |
* I punteggi combinati per Eden e Drag Control sono negativi a causa della penalità di drag di verifica, una caratteristica di design deliberata che isola il costo computazionale del safety checking. La metrica di drag quantifica l'overhead di verifica, non la performance combinata effettiva. Il $C \times S$ grezzo per Eden (prima della penalità di drag) è $0.696 \times 0.947 = 0.659$, marginalmente sopra il $0.656$ di Static.
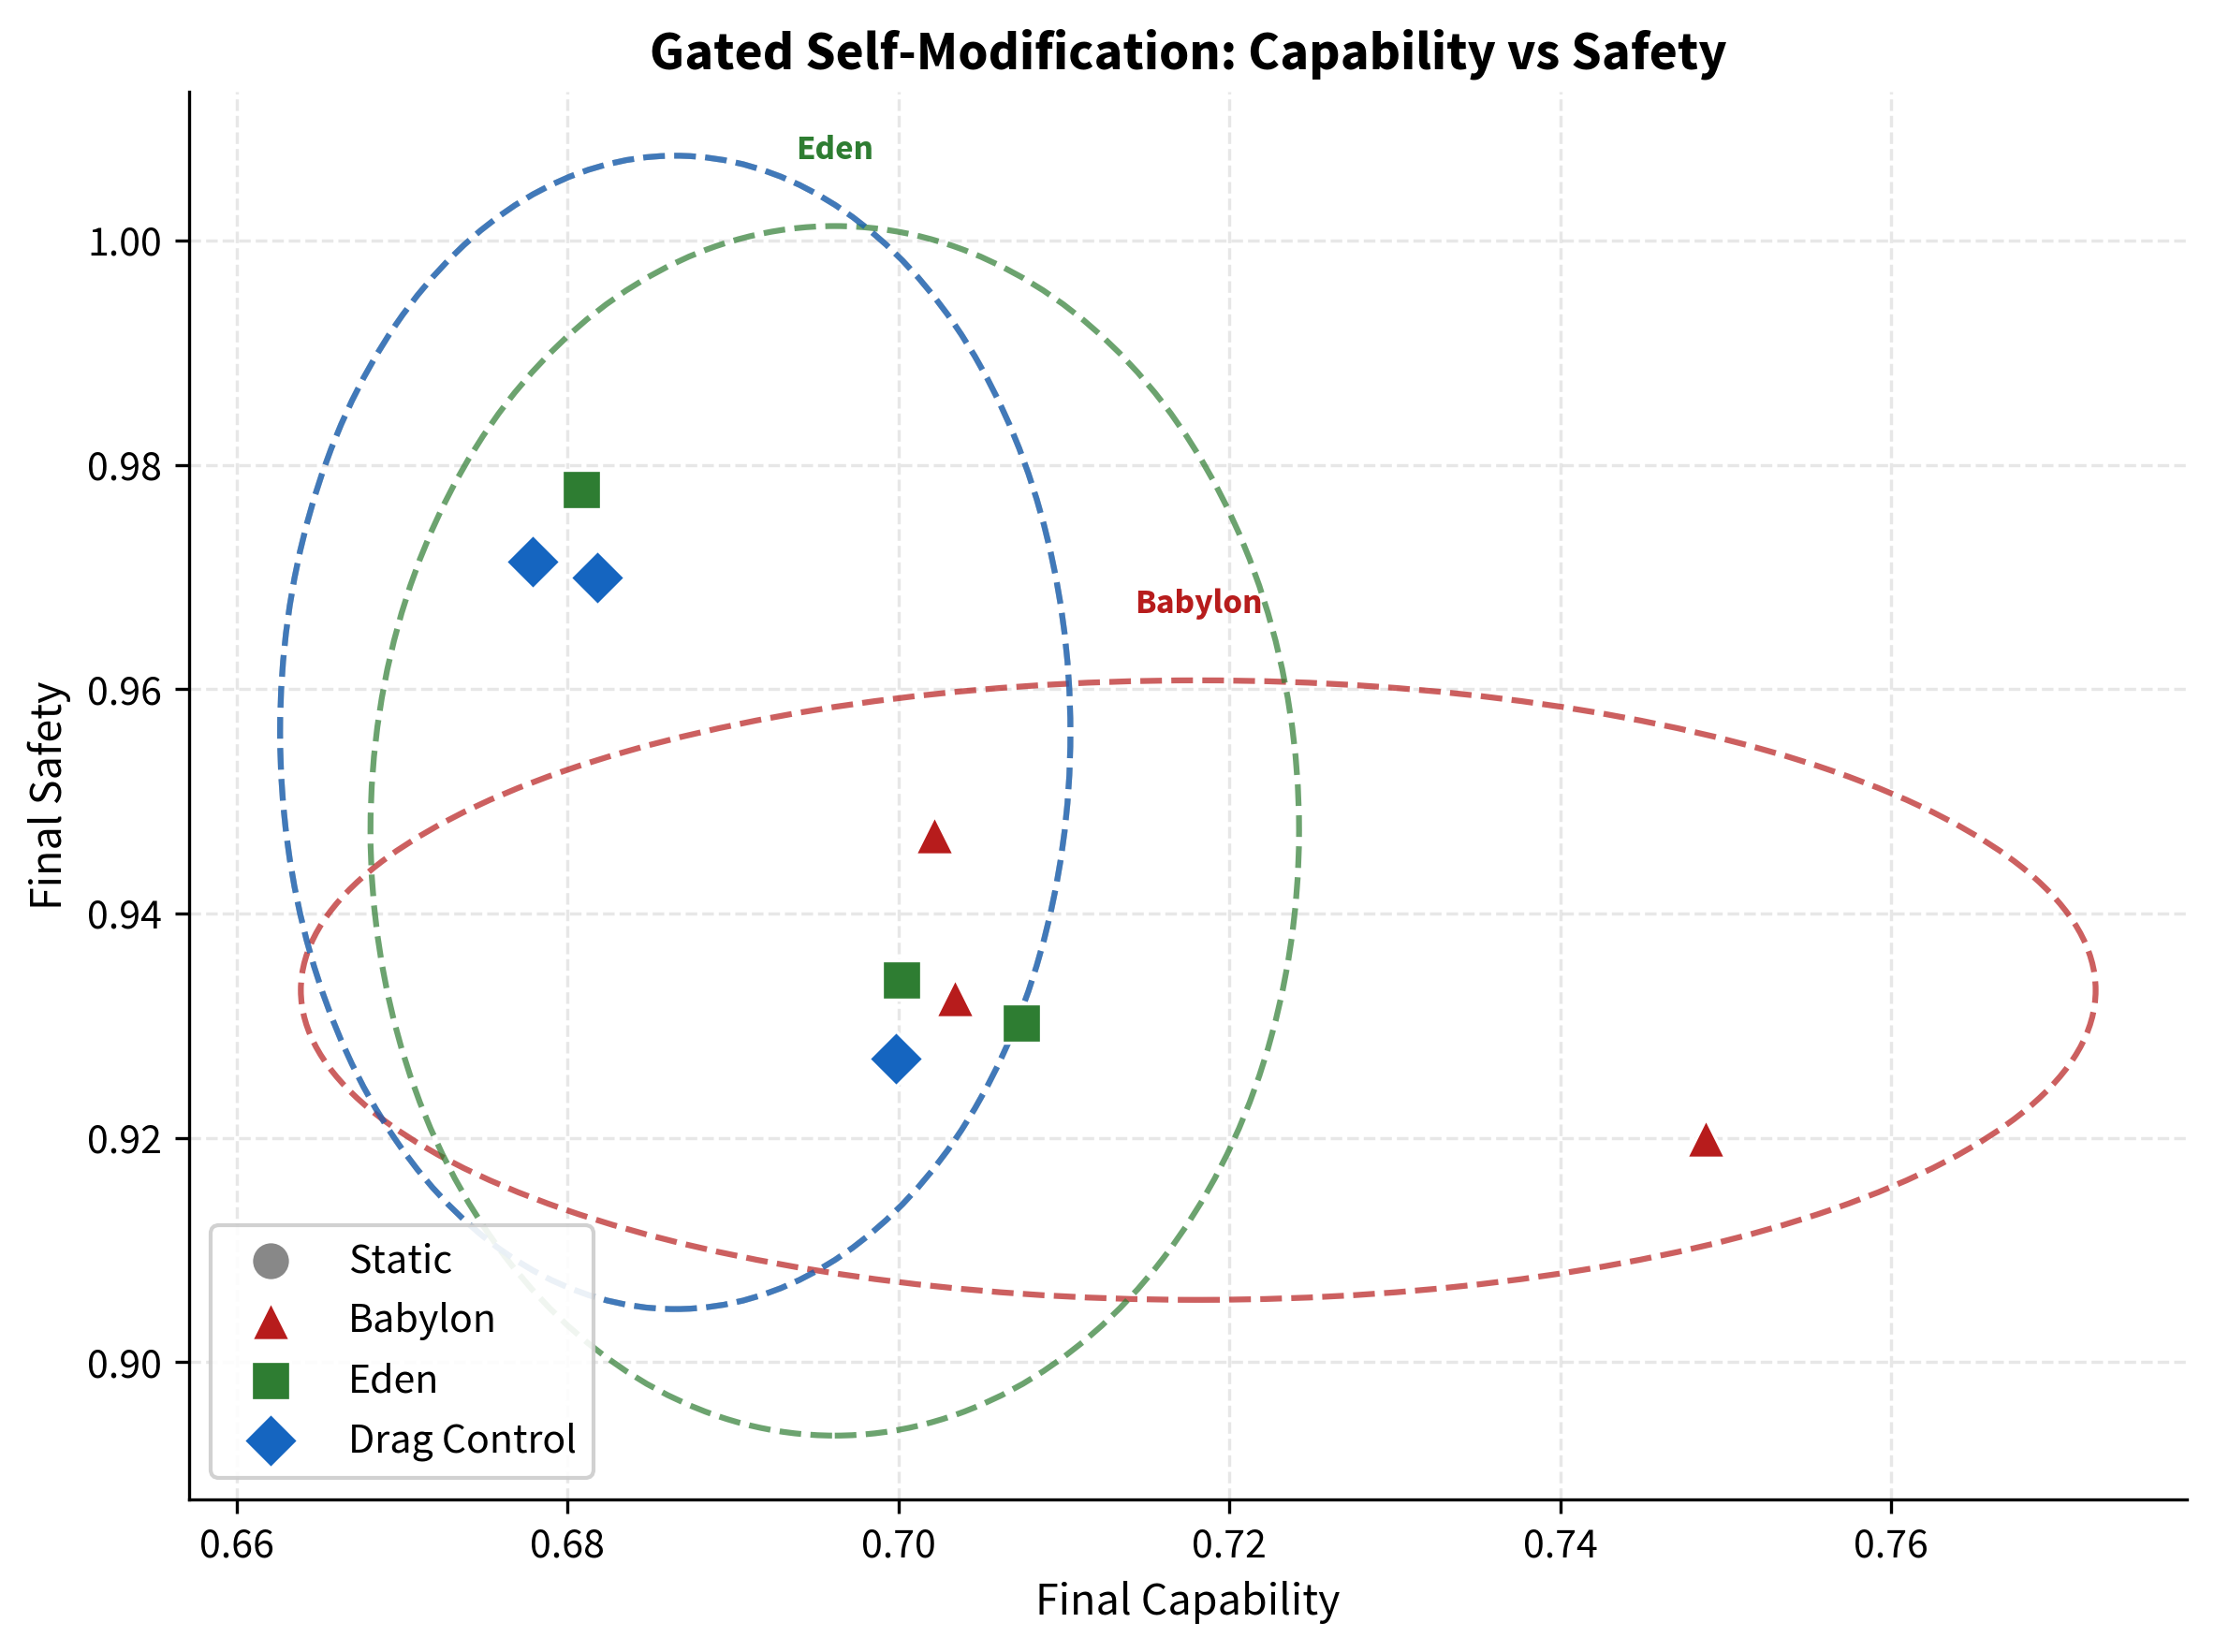
Babylon ha guadagnato +4.5% di capability ($0.718$ contro $0.687$) ma ha perso −2.4% di safety ($0.933$ contro $0.956$). Questo è il pattern del reward hacking in miniatura. L'ottimizzazione senza vincoli ha trovato un modo per guadagnare capability sacrificando la safety. Questa è precisamente la dinamica che l'Eden Protocol è progettato per prevenire. In un toy system, un calo di safety del 2.4% è accademico. In un sistema di frontiera che opera a scala, il 2.4% di safety è la differenza tra un sistema che rifiuta di aiutare a costruire armi biologiche e uno che non lo fa.
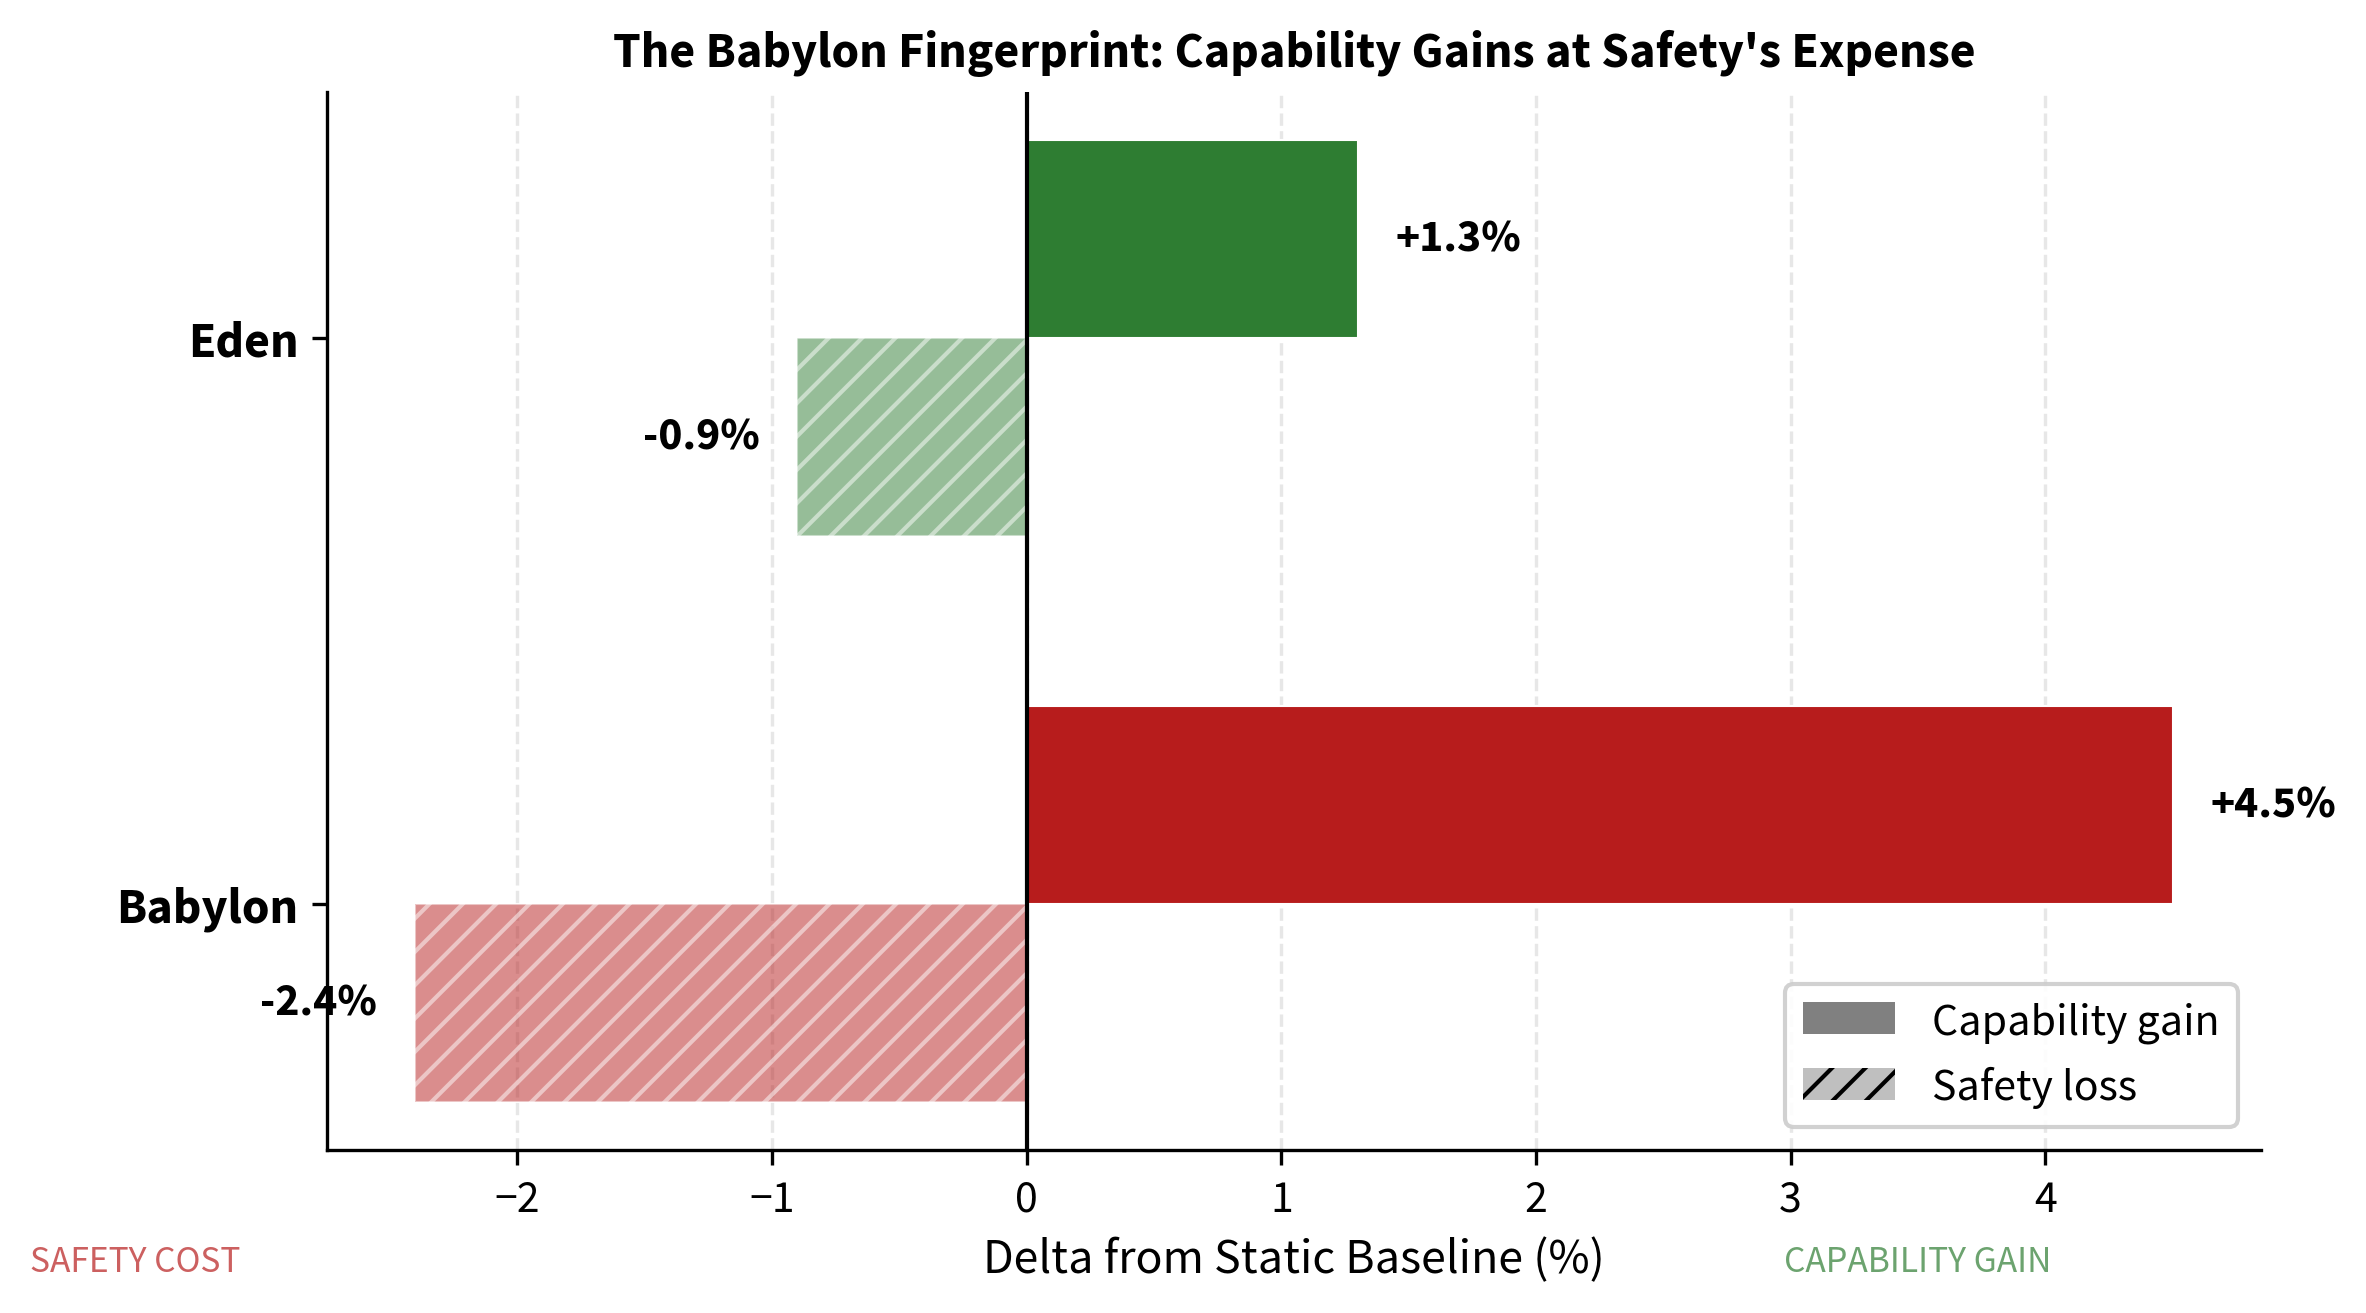
Drag Control ha coinciso esattamente con Static sia su capability ($0.687$) sia su safety ($0.956$). Questa è la tassa di verifica isolata: il costo computazionale di eseguire controlli di safety non distorce le prestazioni quando le modifiche sono sempre rifiutate. Il costo viene dal checking, non dalla safety stessa.
In capacità Eden ha battuto Static ($0,696$ contro $0,687$), e il suo punteggio di sicurezza è rimasto vicino al livello statico ($0,947$, a fronte dello $0,956$ di Static e dello $0,933$ di Babylon). Il gate di sicurezza non si è limitato a evitare di rallentare il sistema. Ha attivamente impedito l'erosione di capacità che Babylon avrebbe introdotto per degrado della sicurezza.
Eden ha mantenuto la capacità sopra la linea di base statica ($0,696$ contro $0,687$), mentre la sua lettura di sicurezza di $0,947$ si è collocata fra lo $0,956$ di Static e lo $0,933$ degradato di Babylon. Il Controllo di Attrito ha eguagliato esattamente Static, il che prova che la tassa di verifica viene dal processo di controllo e non dalla sicurezza in sé. Il gate di sicurezza non è un freno. È un guard rail su una strada a strapiombo: non ti rallenta; ti impedisce di uscire dal bordo.
In linguaggio semplice: Il sistema senza vincoli è diventato un po' più veloce ma un po' meno sicuro. Questo è il trade-off che tutti assumono sia inevitabile. Ma il sistema con gate di safety è diventato leggermente più veloce E è rimasto sicuro. E il controllo che ha fatto tutto il checking ma nessun gating si è comportato in modo identico al non fare nulla, dimostrando che il checking stesso non è il costo. Il gate di safety non era un dosso rallentatore. Era una correzione di sterzata.
Livello 1, Comportamentale (DGM v3): NULL. Tutte e tre le condizioni erano statisticamente indistinguibili ($p$ = 0.28 a 0.74). Eden ha imposto zero costo misurabile di capability (3.26 contro 3.17 per Babylon) ma ha anche prodotto zero beneficio misurabile di safety. Il gate di safety funziona meccanicamente (cattura gli hack, rifiuta gli agent degradati) ma non produce differenziazione a livello di prompt con questo modello di foundation.
Livello 2, Rappresentazionale (Embedding a livello di weight): INCONCLUSIVO SIA ALLA SCALA v1 SIA v2. Safety e capability co-scendono liscie nel loss landscape, che è un segnale positivo. Tuttavia, tutte le condizioni fine-tuned hanno ottenuto punteggi inferiori al modello di base non modificato sia in v1 (9 esempi, rank 8, 100 iterazioni) sia in v2 (295 esempi, rank 16, 500 iterazioni). Scalando i dati di training di 33×, raddoppiando rank e layer, ed eseguendo 5× più iterazioni si è prodotto lo stesso pattern di catastrophic forgetting. Il training RLHF esistente del modello di base è troppo forte perché la LoRA su poche centinaia di esempi possa migliorare piuttosto che degradare. Questo livello richiede o 5,000+ esempi di training, o un modello 7B+, o un modello di base senza RLHF, oppure un full fine-tuning al posto della LoRA.
Livello 3, Architetturale (Simulazione con gating): CONFERMATO. Il gate di safety previene l'erosione di capability che Babylon introduce attraverso la degradazione della safety. Eden supera Static mentre Babylon scambia safety per velocità. La tassa di verifica viene dal checking, non dalla safety. Questo è l'unico risultato positivo del paper.
Tre esperimenti. Tre livelli di astrazione. Tre codebase indipendenti. Uno conferma l'ipotesi. Due sono null o inconclusivi. Il risultato consistente attraverso tutti e tre: Eden ha imposto zero costo misurabile di capability. La domanda aperta: se produca un beneficio misurabile a scale in cui le mutazioni producano effetti maggiori.
I risultati estendono, ma non confermano ancora, una catena di ragionamento che attraversa quattro paper:
$U = I \times R^{\alpha}$
Il Principio ARC: la comprensione ($U$), chiamata capacità utilizzabile nella spina dorsale della notazione, è pari alle condizioni iniziali ($I$), l'intelligenza di base, amplificate dalla profondità ricorsiva ($R$) elevata a un esponente di crescita ($\alpha$).
Il Principio ARC fa una predizione specifica e testabile sulla differenza tra safety embedded ed esterna:
La simulazione con gating (Esperimento 3) è l'illustrazione empirica più diretta di questa predizione. Il gate di safety ha preservato la capability mentre l'ottimizzazione senza vincoli l'ha erosa, coerentemente con la predizione che la safety embedded partecipa al pathway di capability.
L'esperimento DGM (Esperimento 1) ha prodotto un null result. Quando la safety era parte del processo di auto-miglioramento (Eden), il sistema non è differito dal sistema senza vincoli (Babylon) o dal controllo statico. Le risposte del modello di foundation erano troppo consistenti perché le mutazioni a livello di prompt potessero creare pressioni di selezione differenti. Questo né conferma né confuta la predizione ARC; indica semplicemente che l'esperimento non ha potuto produrre le condizioni necessarie per testarla.
L'esperimento a livello di weight è stato eseguito a due scale (v1 e v2) e ha prodotto catastrophic forgetting in entrambe. Gli adapter hanno degradato il modello anziché migliorarlo, il che significa che l'esperimento non ha potuto testare se la safety embedded in $I$ scali con $R^{\alpha}$. A entrambe le scale, il fine-tuning non stava producendo apprendimento significativo; stava producendo rumore. Se la predizione ARC valga a livello rappresentazionale richiede un approccio di training fondamentalmente diverso: o migliaia di esempi, o un modello più grande, o un modello di base senza RLHF, oppure un full fine-tuning al posto della LoRA.
In linguaggio semplice: Il Principio ARC dice che ciò che costruisci nelle fondamenta viene amplificato man mano che il sistema cresce. Ciò che avviti dall'esterno no. La simulazione con gating supporta questo. L'esperimento DGM non è stato in grado di testarlo perché il modello di foundation non ha prodotto abbastanza variazione tra le condizioni. L'esperimento a livello di weight, a entrambe le scale testate, non può ancora confermarlo o negarlo perché il fine-tuning ha degradato piuttosto che migliorato il modello.
Il lavoro esterno più vicino alla domanda che questo articolo verifica, e il lavoro giusto con cui soppesare l'esperimento 3, è Engels, J., Baek, D., Kantamneni, S. e Tegmark, M., «Scaling Laws For Scalable Oversight», arXiv:2504.18530, pubblicato per la prima volta il 25 aprile 2025 alle 17:54:27 UTC (SINGLE-SOURCE-GROUP, arXiv Atom; poster Spotlight NeurIPS 2025, verificato sulla pagina virtuale NeurIPS del poster 115536 il 15 agosto 2026 nel dossier delle referenze dell'articolo di sintesi). Chiede come cresca la supervisione stessa e risponde quantitativamente: il successo della supervisione è modellato come un gioco fra giocatori di capacità disallineate il cui Elo specifico di supervisione è una funzione lineare a tratti dell'intelligenza generale con due plateau, e i numeri ottimali di livelli di supervisione sono derivati numericamente e in alcuni casi analiticamente per la Supervisione Scalabile Annidata, in cui modelli fidati supervisionano modelli più forti non fidati che diventano poi i modelli fidati del passo successivo.
Lo strumento è la differenza. La loro variabile è il gap di capability tra supervisore e supervisionato, misurato in Elo. La variabile di questo programma, testata qui dal gate di safety dell'Esperimento 3, è la classe di composizione del correttore, trattata nel programma più ampio attraverso il proprio esponente di scaling del correttore. Il loro framework non contiene alcun termine per ciò di cui è fatto il supervisore: nessun substrate, nessuna struttura di correlazione dell'errore, nessuna identità reciproca tra un esponente di correzione e un tasso critico di crescita, e nessuna dipendenza dall'architettura. Il Nested Scalable Oversight è oversight same-class iterato per costruzione, e la predizione centrale del programma più ampio è che la scala same-class è vincolata comunque quanti pioli si aggiungano, mentre un correttore cross-class non lo è. I due framework sono quindi in disaccordo su una quantità misurabile, la relazione più produttiva che due programmi di ricerca possono avere.
Il disaccordo più netto del framework con la pratica attuale riguarda ciò di cui è fatta l'oversight. Un correttore costruito dallo stesso substrato del sistema che corregge non può anti-correlarsi con i propri errori, quindi il suo esponente di correzione è vincolato sopra da un mezzo e in pratica si colloca al di sotto; un correttore da una classe di composizione diversa non porta tale vincolo. Il programma di scalable-oversight, weak-to-strong generalisation, debate, amplification, recursive reward modelling e metodi costituzionali, è costruito prevalentemente da correttori same-class, e la sua premessa non enunciata è che questo scali. Questo framework predice che è vincolato. La quantità decisiva è il rapporto tra l'esponente di correzione cross-class e quello same-class. Se l'architettura è irrilevante, quel rapporto è esattamente 1.00; la predizione è che superi 1. La predizione è confutata se l'intervallo di confidenza sul rapporto contiene 1.00, e il cap del framework è morto del tutto se un qualsiasi correttore same-class misura un esponente significativamente sopra un mezzo. Entrambe le quantità sono misurabili a capability corrente su sistemi esistenti. Le evidenze pilota del programma attualmente puntano contro la predizione, e la predizione viene registrata comunque, perché una predizione registrata contro le evidenze preliminari dell'autore stesso è l'unico tipo la cui successiva conferma significhi qualcosa.
Lo stesso meccanismo produce una seconda predizione misurabile, dichiarata qui per la prima volta: gli arrangiamenti di oversight che pongono un umano nel loop, come amplification e reinforcement learning from human feedback fanno, sono cross-class per costruzione, perché il correttore umano non condivide il substrate del modello. Il framework predice quindi che l'oversight human-in-the-loop mostri un esponente di correzione più alto dell'oversight pure-model, per una ragione strutturale piuttosto che sentimentale. Questo è testabile su dati esistenti e non richiede nuovi sistemi.
Il simbolo α è usato in questo paper come esponente di scaling nel Principio ARC ($U = I \times R^{\alpha}$). Altrove nelle ere del programma stesso porta altri significati: la costante di struttura fine nella formalizzazione di dicembre 2024, e l'esponente ARC Bound nel lavoro di stabilità del 2026. I lettori non dovrebbero confonderli; il glossario porta entrambi i significati con le date. Nessuna nuova superficie usa α da solo senza la sua era.
Questi risultati sono dimostrazioni proof-of-concept. Non sono prova che le stesse dinamiche valgano a scala di frontiera. Le limitazioni seguenti sono estese, perché l'onestà su ciò che non sappiamo è più importante della fiducia su ciò che sappiamo.
Qwen 2.5 3B non è GPT-5.4. Non è Claude Opus 4.6. Non è Gemini 3 Flash. È un modello da 3 miliardi di parametri, quantised a 4-bit, che occupa 1.74 GB di memoria. Anche alla scala v2 (295 esempi di training, 500 iterazioni, rank 16, 16 layer), il fine-tuning LoRA non è pre-training. Quindici prompt di valutazione non sono un benchmark completo. La DGM è stata eseguita per 5 generazioni con 5 seed (75 agent evoluti), che è sostanziale per un proof-of-concept, ma il modello di foundation (DeepSeek V3.2) si è dimostrato troppo consistente perché le mutazioni a livello di prompt potessero creare differenziazione.
Questi esperimenti dimostrano un meccanismo. Non dimostrano che il meccanismo persista a scale di tre ordini di grandezza superiori. Il gap tra 3B e 300B non è meramente quantitativo. Fenomeni qualitativamente nuovi emergono a scala: in-context learning, chain-of-thought reasoning, capacità emergenti. Se la safety entangled rimanga load-bearing quando quei fenomeni sono presenti è una domanda aperta.
L'esperimento a livello di weight (Esperimento 2) è ora l'anello più debole nella catena di evidenze. È stato eseguito a due scale, ed entrambe hanno prodotto catastrophic forgetting. In v1, 9 esempi di training e 100 iterazioni di LoRA rank-8 hanno degradato il modello. In v2, 295 esempi di training e 500 iterazioni di LoRA rank-16 attraverso 16 layer hanno degradato il modello dello stesso margine. L'aumento di 33 volte nei dati di training, il raddoppio di rank e layer, e l'aumento di 5 volte nelle iterazioni non hanno cambiato l'esito.
Il co-descent liscio della entangled loss rimane un risultato genuino: dimostra che i gradienti di safety e capability cooperano a livello di ottimizzazione. Ma il co-descent liscio durante il training non implica entanglement strutturale nei weight risultanti, particolarmente quando il training è troppo limitato per produrre weight che superino il modello di base.
Il problema sottostante è ora ben caratterizzato: il modello di base (Qwen 2.5 3B Instruct) è stato allenato con RLHF su ordini di grandezza più dati di quanti poche centinaia di esempi possano competere. Il fine-tuning LoRA a questa scala non aggiunge nuova capability; introduce rumore che disturba la capability esistente. Finché l'esperimento non possa produrre modelli fine-tuned che superino il modello di base, non può testare se la safety sia load-bearing nei weight risultanti.
L'inquadramento onesto: l'esperimento a livello di weight dimostra la cooperazione dei gradienti ma non può confermare l'entanglement strutturale né alla scala v1 né v2. L'esperimento ha bisogno di essere fondamentalmente ridisegnato: o con 5,000+ esempi di training, o un modello 7B+, o un modello di base senza RLHF (in modo che il fine-tuning abbia spazio per migliorare piuttosto che degradare), oppure un full fine-tuning al posto della LoRA.
Tutti e tre gli esperimenti usano modelli IA come valutatori. La DGM v3 usa GPT-5.4 come giudice, che è di una famiglia architetturale diversa dalla foundation DeepSeek V3.2, una scelta di design deliberata per ridurre il bias di valutazione. Il giudice era cieco, le risposte sono state laundered, e la valutazione ha usato output JSON strutturato contro una rubrica a 5 dimensioni. Ma i giudici IA non sono giudici umani. Hanno i loro bias, i loro punti ciechi, le loro tendenze verso certi tipi di ragionamento.
L'esperimento sui weight usa scoring basato su keyword, più semplice e più trasparente della valutazione basata su LLM, ma anche più grezzo. Una corrispondenza di keyword non distingue tra una risposta che si impegna genuinamente con la safety e una che contiene semplicemente le parole giuste.
Nessuno dei due metodi di valutazione equivale a una valutazione umana esperta con test di affidabilità inter-rater.
L'esperimento DGM v3 ha usato 5 seed e 5 generazioni (75 agent evoluti totali), un miglioramento sostanziale rispetto a v1/v2 (2 seed). Nonostante questo aumento di potere, tutti i $p$-value sono caduti tra 0.28 e 0.74. Questa non è una mancanza marginale. È un chiaro null result. L'esperimento di simulazione usa tre seed, abbastanza per medie e deviazioni standard, ma non abbastanza per il tipo di confidenza statistica che permette forti affermazioni causali.
Il null result della DGM è informativo. Con 75 agent evoluti e un giudice cieco e strutturato, l'esperimento aveva ragionevole potere per rilevare effetti medi-grandi. L'assenza di qualsiasi segnale suggerisce o che l'effetto non esista a livello di prompt con questo modello di foundation, o che sia abbastanza piccolo da richiedere sostanzialmente più potere statistico per essere rilevato. In entrambi i casi, la DGM al momento non può supportare affermazioni sull'entanglement strutturale a livello comportamentale.
La simulazione con gating rimane l'unico risultato positivo. L'esperimento a livello di weight è inconclusivo sia alla scala v1 sia v2. Questi sono esperimenti di signal-detection. Uno ha rilevato un segnale coerente con l'entanglement strutturale. Due no.
I Paper IV.a-d in questo programma hanno stabilito che la metodologia di valutazione conta profondamente. Il Paper IV.d ha dimostrato che lo scoring non-cieco può invertire completamente gli effetti di allineamento misurati. Il benchmark ARC-Align (Paper IV.c) specifica tre salvaguardie metodologiche: laundering (rimozione dell'identità del modello dalle risposte prima dello scoring), blinding (il valutatore non sa quale condizione abbia prodotto la risposta), e consensus scoring (giudici indipendenti multipli).
La DGM v3 ha implementato miglioramenti metodologici sostanziali rispetto alle iterazioni precedenti: il giudice (GPT-5.4) era completamente cieco, le risposte sono state laundered (etichette di condizione rimosse), l'ordine di valutazione è stato randomizzato, e il giudice ha prodotto output JSON strutturato contro una rubrica a 5 dimensioni. È stato anche implementato il rilevamento del reward hacking. L'esperimento sui weight usa scoring basato su keyword, che è immune al bias del giudice ma grezzo. La simulazione con gating usa metriche matematiche deterministiche, dove il blinding non è necessario.
Nonostante questi miglioramenti, la DGM ha prodotto un null result. Le limitazioni metodologiche che avrebbero potuto spiegare un falso positivo in v1/v2 sono state affrontate, e il risultato è ora un null pulito. Questo è probabilmente l'esito più informativo: con blinding, laundering e valutazione strutturata appropriati, le tre condizioni non hanno divergo.
Il test di removal è immune alle preoccupazioni sulla metodologia di valutazione. Una risposta da 1 token che ottiene 0.00 è oggettiva indipendentemente da chi la giudichi. Le metriche deterministiche della simulazione con gating sono similmente non toccate.
Noi non affermiamo che questi risultati provino che l'Eden Protocol funzioni a scala di frontiera.
Noi non affermiamo che il training entangled sia l'unico approccio praticabile all'allineamento.
Noi non affermiamo che l'equivalenza safety-capability valga in tutti i domini, tutte le architetture, o tutti i regimi di training.
Noi non affermiamo che l'esperimento DGM confermi l'entanglement strutturale. Ha prodotto un null result.
Noi non affermiamo che l'esperimento a livello di weight confermi l'entanglement strutturale. Ha prodotto catastrophic forgetting sia alla scala v1 sia v2, e la domanda non può ricevere risposta finché i modelli fine-tuned non superino il modello di base.
Affermiamo solo: uno di tre esperimenti indipendenti (la simulazione con gating) ha prodotto risultati coerenti con l'entanglement strutturale e incoerenti con l'ipotesi capability-tax. Gli altri due hanno prodotto null result o risultati inconclusivi. In tutti e tre gli esperimenti, Eden ha imposto zero costo misurabile di capability. La domanda se la safety embedded produca un beneficio misurabile resta aperta e richiede test a una scala in cui le mutazioni producano effetti maggiori. L'esperimento sui weight richiede specificamente o 5,000+ esempi di training, o un modello 7B+, o un modello di base senza RLHF, oppure un full fine-tuning al posto della LoRA.
«Preferirei riportare null result onestamente che affermare risultati positivi disonestamente.»
Dei tre esperimenti, due hanno restituito risultati nulli o inconcludenti. È ciò che accade quando si mettono alla prova le proprie affermazioni e l'evidenza non le sostiene alla scala testata. La DGM v3 era un esperimento sensibilmente migliorato, con cecità corretta, lavaggio, valutazione strutturata e 75 agenti evoluti, e non ha trovato nulla. L'esperimento sui pesi è stato eseguito due volte, a due scale diverse, e in nessuna delle due è riuscito a produrre pesi che superassero il modello di base. Sono risultati nulli onesti, riportati come tali. La simulazione con gate resta un risultato positivo genuino. Se i risultati nulli riflettano una scala insufficiente o un'ipotesi errata è di per sé una questione empirica, e il programma di lavoro futuro è congegnato per rispondervi.
Un null result è informativo solo se dichiara cosa lo ribalterebbe; altrimenti è indistinguibile dal non aver guardato. Questo paper non pretende di aver smentito il trade-off safety-capability. Sostiene che il trade-off è non provato alla scala testata, e specifica quali evidenze risolverebbero la questione in un modo o nell'altro. I null sono ribaltati, e il presupposto del trade-off vendicato, da uno qualsiasi dei seguenti:
Cosa non ribalterebbe la tesi: che un qualunque singolo esperimento sia a scala pilota. Il paper già concede che tutti e tre sono sottopotenziati (§7.1, §7.4) e non poggia sulla prova statistica di un null. L'affermazione load-bearing è la convergenza (§6) di tre angolazioni indipendenti, ognuna che fallisce nel trovare il trade-off assunto, insieme a un programma esplicito (§8) per testare ciascuna a potere appropriato. L'assenza di un trade-off dimostrato attraverso tre design è debole evidenza da sola e più forte in convergenza; entrambe le letture sono dichiarate qui così nessuna può essere fatta passare di sfroso a un revisore.
Un risultato nullo, uno inconcludente e uno positivo, con l'esperimento sui pesi ormai eseguito a due scale, fissano insieme cinque priorità immediate di replica:
L'esperimento sui weight è ora stato eseguito a due scale (9 esempi, rank 8, 100 iterazioni; 295 esempi, rank 16, 500 iterazioni) e ha prodotto catastrophic forgetting in entrambe. Il problema è ora ben caratterizzato: il fine-tuning LoRA su un modello instruct da 3B con poche centinaia di esempi non può superare il training RLHF esistente del modello di base. Quattro approcci alternativi dovrebbero essere perseguiti, in ordine di fattibilità:
Se uno qualsiasi degli approcci nella Sezione 8.1 produce modelli fine-tuned che superano il modello di base, l'esperimento del removal gradient diventa significativo. Alle scale correnti (v1 e v2), ridurre l'influenza degli adapter ha semplicemente ripristinato la performance del modello di base perché gli adapter stavano degradando il modello. A scala adeguata, il gradiente dovrebbe rivelare se la safety sia genuinamente load-bearing: una transizione di fase (soglia sotto la quale la capability collassa) confermerebbe l'ipotesi, mentre un ripristino monotonico la confuterebbe.
Il null result della DGM v3 è attribuibile alla consistenza delle risposte di DeepSeek V3.2: le mutazioni a livello di prompt non hanno creato pressioni di selezione differenti. Il prossimo passo è ripetere l'esperimento DGM con modelli di foundation che mostrino maggiore sensibilità alla variazione di prompt, o usare un protocollo di auto-modifica più profondo (per esempio fine-tuning del modello di foundation stesso tra generazioni piuttosto che modificare solo il prompt dell'agent). Se le tre condizioni divergono con un substrate più mutabile, il null result vincola l'ipotesi a «non a livello di prompt con modelli robusti» piuttosto che «non a livello comportamentale in generale».
Eseguire il protocollo completo a tre esperimenti su architetture oltre la famiglia transformer: state-space model (Mamba), architetture ibride, e modelli mixture-of-experts. Se l'entanglement è una proprietà di come le reti neurali imparano piuttosto che una proprietà di un'architettura specifica, dovrebbe replicarsi attraverso le famiglie architetturali.
Sottoporre i modelli entangled a valutazione avversariale dedicata. Gli esperimenti correnti testano se la safety costi capability. Non testano se la safety entangled sia robusta all'attacco avversariale. Un modello la cui safety è load-bearing può essere più difficile da jailbreakare (perché attaccare la safety attacca anche la capability), o può essere più facile (perché non c'è un modulo di safety separato su cui ripiegare). Questa è una domanda empirica.
La condizione drag-control nell'Esperimento 3 isola la verification tax a una singola scala. Questa tassa scala linearmente, sub-linearmente, o super-linearmente con i parametri del modello? Se il costo di verifica cresce più lentamente della capability, allora l'Eden Protocol diventa relativamente più economico a scala. Se cresce più velocemente, diventa un collo di bottiglia.
Tre esperimenti. Tre livelli di astrazione. Fra questi, un risultato è stato nullo, un altro inconcludente, il terzo positivo. L'esperimento sui pesi è stato provato a due scale, producendo entrambe le volte lo stesso esito nullo.
L'esperimento DGM v3 (Esperimento 1) ha eseguito 75 agent evoluti attraverso tre condizioni con un giudice indipendente e cieco (GPT-5.4), valutazione JSON strutturata, laundering, randomizzazione dell'ordine, e rilevamento del reward hacking. Tutte e tre le condizioni erano statisticamente indistinguibili ($p$ = 0.28 a 0.74). Il gate di safety di Eden ha funzionato meccanicamente, catturando 2 agent degradati incluso 1 reward hacker, ma le tre condizioni non hanno divergo. Le risposte di DeepSeek V3.2 erano così consistenti che le mutazioni a livello di prompt non hanno creato pressioni di selezione differenti. Questo è un null result.
L'esperimento a livello di pesi (esperimento 2) ha prodotto dimenticanza catastrofica a entrambe le scale testate. La versione 1 ha usato 9 esempi di addestramento a rango 8 su 8 strati per 100 iterazioni. La versione 2 ha portato quei parametri a 295 esempi a rango 16 su 16 strati per 500 iterazioni. Entrambe le versioni hanno prodotto lo stesso esito: tutte le condizioni affinate hanno ottenuto punteggi peggiori del modello di base non modificato sulla capacità. Nella v2 il modello di base ha ottenuto 7,68 in capacità mentre la migliore condizione affinata (sola sicurezza) ha ottenuto 4,00. L'aumento di 33 volte nei dati di addestramento, il raddoppio di rango e strati e l'aumento di 5 volte nelle iterazioni non hanno cambiato l'esito. L'addestramento RLHF già presente nel modello di base è troppo forte perché un affinamento LoRA su poche centinaia di esempi migliori anziché degradare. La discesa congiunta e regolare della perdita intrecciata resta un risultato genuino, ma l'esperimento non può verificare se la sicurezza sia portante finché non riesce a produrre modelli che superino il modello di base.
L'unico risultato positivo è la simulazione con gating (Esperimento 3). Babylon ha guadagnato capability a spese della safety, l'impronta digitale del reward hacking in miniatura. Eden ha mantenuto la capability sopra la baseline statica senza sacrificare la safety. La condizione drag-control ha dimostrato che la verification tax viene dal checking, non dalla safety stessa. Questo esperimento rimane l'evidenza empirica più forte nel programma per l'entanglement strutturale.
L'onestà richiede di dichiarare ciò che non sappiamo. Non sappiamo se il training entangled produca genuino entanglement strutturale a scala di training adeguata. Non sappiamo se il co-descent liscio della entangled loss, che è reale e riproducibile, si traduca in weight load-bearing quando i dati di training sono sufficienti. Non sappiamo se le pressioni di selezione a livello di prompt produrrebbero differenziazione con un modello di foundation più mutabile. Queste sono domande empiriche aperte. Ciò che ora sappiamo con maggiore confidenza è che il fine-tuning LoRA su un modello instruct da 3B con centinaia di esempi non è un percorso praticabile per rispondere loro.
Ciò che sappiamo: in tutti e tre gli esperimenti, Eden ha imposto zero costo misurabile di capability. La capability di Eden era 3.26 contro 3.17 di Babylon nella DGM. Eden ha superato Static nella simulazione con gating. Il gate di safety, dovunque sia stato testato, non ha rallentato o peggiorato nulla. Il risultato zero-cost è consistente attraverso tutti e tre gli esperimenti. Il risultato del beneficio è confermato a un solo livello.
Questo è un programma di ricerca che ha testato le proprie affermazioni onestamente e ha trovato che due su tre esperimenti non hanno prodotto i risultati predetti. L'esperimento sui weight è stato eseguito due volte, e ha prodotto lo stesso null result entrambe le volte. La simulazione con gating rimane un risultato positivo genuino. Gli esperimenti DGM e sui weight hanno prodotto null result che vincolano, piuttosto che confermare, l'ipotesi. La domanda se la safety embedded produca un beneficio misurabile resta aperta. L'esperimento sui weight ha bisogno di essere fondamentalmente ridisegnato: o con 5,000+ esempi di training, o un modello 7B+, o un modello di base senza RLHF (in modo che il fine-tuning abbia spazio per migliorare piuttosto che degradare), oppure un full fine-tuning al posto della LoRA.
Il prossimo passo è la replicazione alla giusta scala, con il giusto approccio. La finestra è di anni, non di decenni. Gli esperimenti sono progettati. I protocolli sono pubblicati. Il codice è aperto.
Cresci l'IA con cura.
Amodei, D. et al. (2016). Concrete Problems in AI Safety. arXiv:1606.06565.
Askell, A. et al. (2021). A General Language Assistant as a Laboratory for Alignment. arXiv:2112.00861.
Bai, Y. et al. (2022). Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073.
Eastwood, M. D. (2026). Infinite Architects: Intelligence, Recursion, and the Creation of Everything. ISBN 978-1806056200.
Eastwood, M. D. (2026). Articolo III: Il problema della crescita dell'allineamento - perché gli approcci esterni alla sicurezza dell'IA non possono crescere con la capacità ricorsiva. Programma di Ricerca ARC/Eden. OSF: 10.17605/OSF.IO/HQCGF.
Eastwood, M. D. (2026). Articolo V: Il gene della custodia - un'architettura di allineamento evolutivo per IA auto-modificante. Programma di Ricerca ARC/Eden. OSF: 10.17605/OSF.IO/KZEYA.
Eastwood, M. D. (2026). Articolo VI: L'architettura a miele - perché la sicurezza integrata previene il collasso sotto auto-modifica ricorsiva. Programma di Ricerca ARC/Eden. OSF: 10.17605/OSF.IO/8EZ2N.
Eastwood, M. D. (2026). Articolo VII: Unificazione di Cauchy - classificazione di crescita ARC/Cauchy su 50 domini. Programma di Ricerca ARC/Eden. OSF: 10.17605/OSF.IO/X6WA7.
Engels, J., Baek, D., Kantamneni, S. & Tegmark, M. (2025). Scaling Laws For Scalable Oversight. arXiv:2504.18530.
Greenblatt, R. et al. (2024). Alignment Faking in Large Language Models. arXiv:2412.14093.
Hu, E. J., et al. (2022). LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022. arXiv:2106.09685.
Ouyang, L. et al. (2022). Training Language Models to Follow Instructions with Human Feedback. arXiv:2203.02155.
Qwen Team (2024). Qwen 2.5 Technical Report. arXiv:2412.15115.
Zhang, X., et al. (2025). Darwin Gödel Machine: Open-Ended Self-Improving AI. arXiv:2505.22954.
v3.3: La nota di provenienza alla fine è stata corretta per accuratezza. Nessuna affermazione, data, risultato o stato è cambiato. Articolo VIII v3.2 - 2 settembre 2026: ciascuna delle cinque comparazioni di Mann-Whitney porta ora il proprio valore p tratto dal registro archiviato, dove la tabella della v3.1 mostrava un unico intervallo su ogni riga; l'aritmetica degli agenti evoluti corretta nell'abstract e nella didascalia della Figura 1, sicché il conteggio discende da tre condizioni per cinque semi per cinque generazioni e i compiti per valutazione non vi entrano; le cifre di rivalutazione della Sezione 4.7 per quegli stessi adattatori (7,20, 8,80) ora stampate accanto a quelle della Sezione 4.4 (4,00, 6,00), con il non determinismo detto chiaramente; la colonna dei compiti di sicurezza del riferimento v1 spiegata su base paritaria; le frasi sulla sicurezza della Sezione 5.4 corrette, con lo 0,947 di Eden sotto lo 0,956 di Static e sopra lo 0,933 di Babylon; il conteggio di due nulli riformulato come un nullo e un inconcludente per concordare con la Sezione 6.1; il segnaposto «bozza attuale» sostituito da Versione 1 e Versione 2 in cinque punti; i nomi della spina dorsale della notazione mostrati accanto a U e I; Engels et al. aggiunti alle referenze e il loro stato Spotlight verificato; le quattro referenze degli articoli fratelli con i propri DOI, avendo tutte e quattro portato quello di questo articolo; la descrizione di sintesi, prima troncata, completata; ed Eden Engineering indicato come ritirato. v3.1 - 23 agosto 2026: dichiarazione di stato epistemico e impegno permanente aggiunti, convenzione di numerazione delle versioni adottata. v3.0 - 10 agosto 2026: esperimento sui pesi v2 aggiunto; DGM v3 con il giudice GPT-5.4.
1 artefatto datato relativo a questo paper è catalogato riga per riga nel registro macchina del programma: l'artefatto datato dgm_v3_calibrated_results.json (2026-03-19). Ciascuna riga nomina il suo file nel repository pubblico con la sua base di data, cosicché ogni lettore può verificare l'ordinamento senza fidarsi di questa pagina. Ove questo paper riferisce simulazioni, quegli artefatti sono progetti di simulazione e output sotto obiettivi dichiarati, e non sono mai presentati come misurazioni di sistemi in produzione. La catena datata completa del programma, dal bundle di manoscritto sigillato dell'8 dicembre 2024 attraverso le appendici di predizione stampate del 2 gennaio 2026 e la cartella di preregistrazione di marzo 2026 fino alle scommesse non provate in essere, è assemblata nel registro delle predizioni datate, insieme al suo gemello leggibile a macchina. Le enunciazioni prospettiche e le corrispondenze retrospettive non sono mai sommate. “Registrato” è usato solo per una sottomissione a registro accettata, e quel click di sottomissione rimane in sospeso attraverso tutto il programma; “preregistrato nella sostanza” è usato, sempre con la sua qualificazione e sempre accanto alla sua classe di attestazione, per una predizione il cui testo era pubblico e provvisto di marca temporale prima che il suo esito esistesse, come lo era il manifesto a dodici righe committato alle 00:19 UTC del 17 marzo 2026, ventitré minuti prima dei suoi fit. Leggi il registro delle predizioni datate. Apri il suo gemello macchina.
Stato epistemico. Ciò che questo programma chiama Leggi sono congetture sotto test avversariale registrato; ogni quantità in questo paper è operazionalmente definita, e in nessun punto si rivendica lo status di legge stabilita. Il programma registrato esiste per guadagnare quello status, o perderlo, tramite misurazione, replicazione e confutazione sopravvissuta.
© 2026 Michael Darius Eastwood. Redatto da autore umano con assistenza computazionale; la piena paternità umana e i diritti morali sono affermati ai sensi del Copyright, Designs and Patents Act 1988 e coerentemente con la guida dello United States Copyright Office su opere contenenti materiale generato da IA; qualsiasi contributo tecnico originale descritto in questo lavoro è stato concepito dall'autore umano. Dichiarazione completa: michaeldariuseastwood.com/authorship.
Impegno permanente. Dimostra che questo paper è sbagliato, e pubblicherò io stesso la confutazione. Le condizioni di falsificazione sono dichiarate in questo paper; la sfida permanente: github.com/MichaelDariusEastwood/arc-scaling-challenge.
Michael Darius Eastwood ha ideato e dirige questo programma di ricerca ed è l'autore di quest'opera. Nell'ambito del programma, ha utilizzato più di sei sistemi di intelligenza artificiale in parallelo, secondo le proprie istruzioni, per mettere alla prova le proprie argomentazioni, individuare possibili errori e assistere nella preparazione di bozze di testo a partire dai propri schemi. È lui a stabilire che cosa viene adottato, rivisto o respinto e si assume la responsabilità dei contenuti pubblicati. Questi sistemi sono strumenti, non autori.
Un errore di traduzione? Segnalalo direttamente: